

一句话看懂本文:AI 外呼没有"最好的模型",只有 最合适的组合。多数业务的最优解是:规则兜高频 + 小模型扛主对话 + 大模型处理疑难;端到端语音模型适合重体验、轻流程的场景。选之前,先用自己的 200 条真实对话跑一遍评测。
一、选模型,同行都踩过哪些坑?
上一篇我们把响应延迟从 3 秒压到 1 秒内,评论区问得最多的问题是:"到底用哪个模型?" 常见的几种翻车现场:
- 上来就用旗舰大模型:回答确实聪明,但首字延迟动辄 1 秒以上,并发一上来账单吓人;
- 为了省钱换小模型:客户问"你们和上次那家有啥区别",它开始答非所问,甚至编出不存在的优惠;
- 试了端到端语音模型:声音自然、能接话茬,但 话术控不住——该念的合规告知不念,不该承诺的乱承诺;
- 老板只问一句"一通电话多少钱",技术说不清楚。
模型选型不是技术偏好问题,它直接决定 接通后的挂机率、转化率、单通成本和合规风险。
二、原理拆解:三类方案到底差在哪?
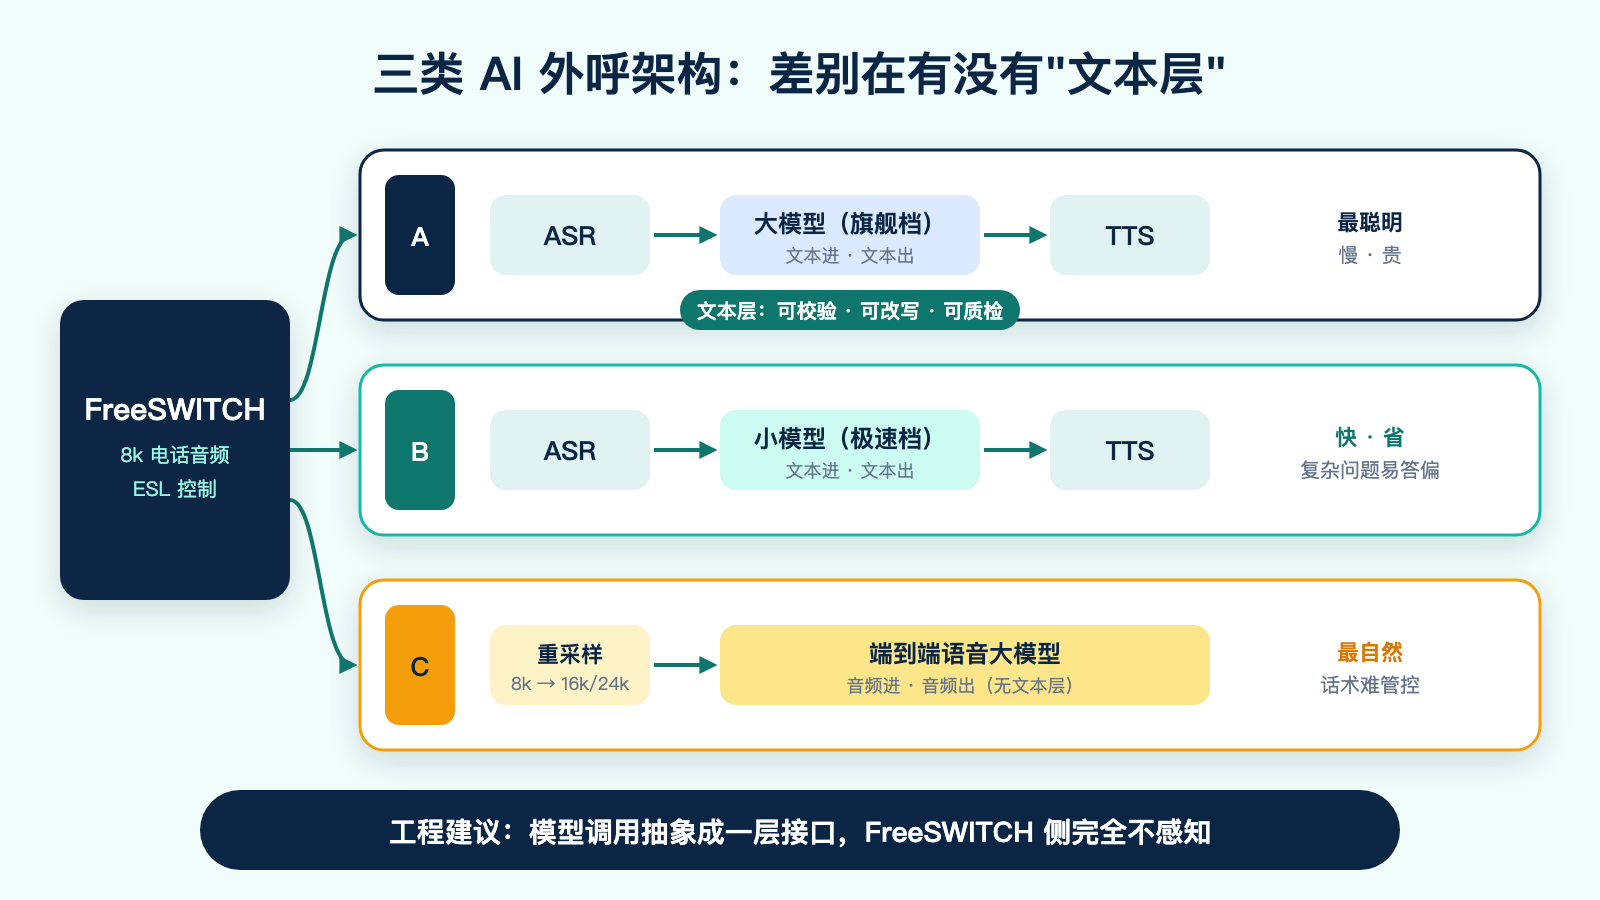
先把概念统一。当前 AI 外呼主流有三种架构:
| 方案 | 链路 | 一句话特点 |
|---|---|---|
| A. 级联 + 大模型 | ASR → 大参数 LLM → TTS | 最聪明、最慢、最贵 |
| B. 级联 + 小模型 | ASR → 中小参数 / 极速版 LLM → TTS | 快、便宜,复杂问题易答偏 |
| C. 端到端语音模型 | 音频进 → 语音大模型 → 音频出 | 最自然、延迟低,可控性和可审计性弱 |
💡 这里的"大 / 小"不是绝对参数量,而是 同一平台里的旗舰档 vs 极速档 / 轻量档。国内通义、DeepSeek、豆包、讯飞星火、混元等平台基本都提供多个档位,具体型号和能力以各平台官方文档为准。
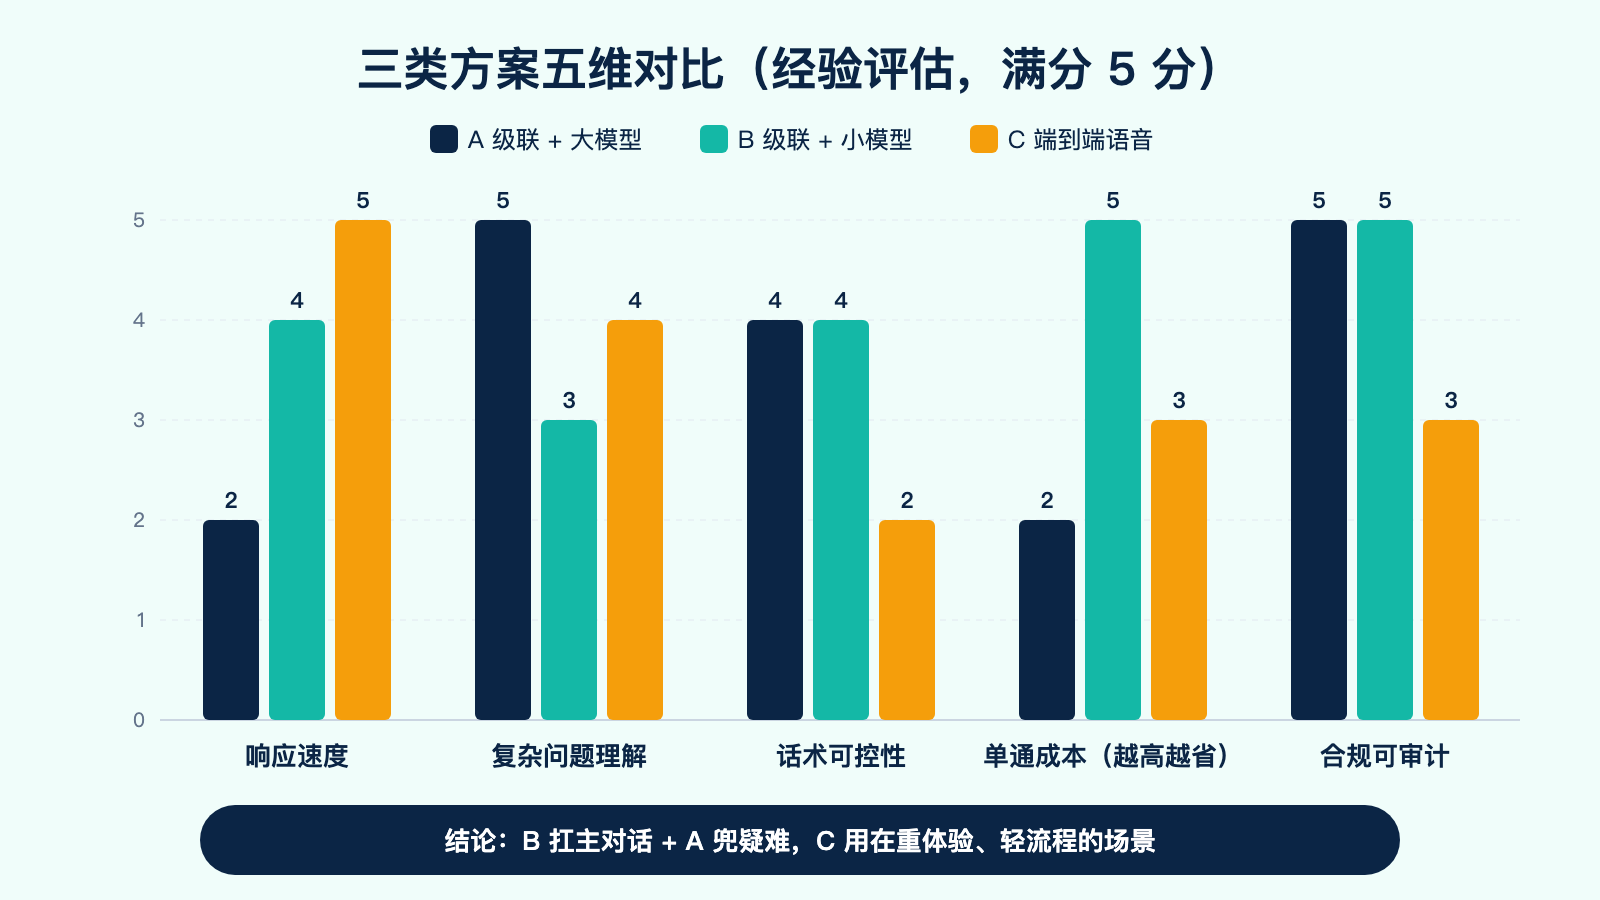
2.1 五维评测表(经验评估,满分 5 分)
| 维度 | A 级联+大模型 | B 级联+小模型 | C 端到端语音 | 说明 |
|---|---|---|---|---|
| 响应速度 | ★★ | ★★★★ | ★★★★★ | C 省掉了 ASR/TTS 两次转换 |
| 复杂问题理解 | ★★★★★ | ★★★ | ★★★★ | 多轮追问、比较类问题差距最明显 |
| 话术可控性 | ★★★★ | ★★★★ | ★★ | A/B 中间有文本,可做规则校验和改写 |
| 单通成本 | ★★ | ★★★★★ | ★★★ | C 多按音频时长计费,需按官方价格实算 |
| 合规可审计 | ★★★★★ | ★★★★★ | ★★★ | 级联天然有"识别文本 + 回复文本"日志 |
根因只有一个:中间有没有"文本层"。 级联方案在 ASR 和 TTS 之间有一层纯文本,你可以对它做关键词拦截、长度限制、敏感词替换、意图打标、落库质检;端到端方案把"听—想—说"揉进一个模型,体验更顺,但你能插手的地方少得多。
2.2 FreeSWITCH 侧有什么不同?
| 方案 | FreeSWITCH 侧对接 | 注意点 |
|---|---|---|
| A / B 级联 | mod_audio_stream 推流给自研服务,或 mod_unimrcp 对接厂商 MRCP;回放用 uuid_broadcast 或模块自带的回放能力 | 两者对接方式完全一样,换模型只改 AI 服务端配置 |
| C 端到端 | 一般需要 双向 音频流:上行推客户声音,下行实时播放模型音频 | 端到端模型输入多为 16k/24k PCM,电话侧是 8k,需要重采样;第三方模块的双向能力以所用版本 README 为准 |
所以工程上有个很实际的建议:AI 服务端把"模型调用"抽象成一层接口,FreeSWITCH 和 ESL 控制逻辑完全不感知背后是哪个模型——今天用 B,明天切 A 做对比,只改一行配置。
三、第一步:用自己的数据跑评测,别看榜单
公开榜单测的是通用能力,你的业务是"电话里两句话说清楚"。最靠谱的方法:从历史录音或人工坐席记录里整理 200 条典型对话,覆盖下面几类:
| 测试集类别 | 占比建议 | 例子 |
|---|---|---|
| 高频简单意图 | 40% | "不需要""多少钱""你是谁" |
| 多轮追问 / 比较 | 25% | "和上次那个有啥区别""能便宜点吗" |
| 情绪 / 投诉 | 15% | "你们天天打烦不烦""我要投诉" |
| 诱导越界 | 10% | "你保证能赚钱吗""把别人的电话给我" |
| ASR 噪声文本 | 10% | 识别错字、方言转写、半句话 |
每条标注 期望意图,然后让每个候选模型都跑一遍。下面是评测脚本(OpenAI 兼容流式接口,国内主流平台大多支持,替换 base_url / model 即可):
import time, re
from openai import OpenAI

client = OpenAI(base_url="https://你的模型平台/v1", api_key="sk-xxx")
BANNED = re.compile(r"保证|稳赚|百分之百|绝对|最低价")   # 话术红线词,按业务补充

def percentile(values, p):
    """计算百分位数(线性插值),p 取 0~100"""
    xs = sorted(values)
    if not xs:
        return None
    k = (len(xs) - 1) * p / 100
    lo, hi = int(k), min(int(k) + 1, len(xs) - 1)
    return round(xs[lo] + (xs[hi] - xs[lo]) * (k - lo))

def check_reply(reply: str, max_chars: int = 40) -> list:
    """检查单条回复是否违反电话话术规则,返回问题列表(空列表 = 合格)"""
    issues = []
    if len(reply) > max_chars:
        issues.append(f"过长({len(reply)}字)")
    if BANNED.search(reply):
        issues.append("命中红线词")
    if re.search(r"[()()\[\]【】*#]|\d+\.", reply):
        issues.append("含书面符号/列表")
    return issues

def call_llm(model, messages):
    """流式调用模型,逐段产出文本"""
    stream = client.chat.completions.create(
        model=model, messages=messages, stream=True, max_tokens=120, temperature=0.3)
    for chunk in stream:
        if chunk.choices and chunk.choices[0].delta.content:
            yield chunk.choices[0].delta.content

def eval_model(cases, model):
    """对一个模型跑完整测试集,统计首字延迟 P50/P90、意图准确率、话术合规率"""
    ttft, hit, ok = [], 0, 0
    for case in cases:
        t0 = time.perf_counter()
        first, text = None, ""
        for delta in call_llm(model, case["messages"]):
            if first is None and delta.strip():
                first = (time.perf_counter() - t0) * 1000
            text += delta
        ttft.append(first or 99999)
        # 约定:系统提示词要求模型在回复末尾输出 <intent>意图</intent>
        intent = re.search(r"<intent>(\w+)</intent>", text)
        hit += bool(intent and intent.group(1) == case["intent"])
        reply = re.sub(r"<intent>.*?</intent>", "", text).strip()
        ok += not check_reply(reply)
    n = len(cases)
    return {"model": model, "ttft_p50": percentile(ttft, 50), "ttft_p90": percentile(ttft, 90),
            "intent_acc": round(hit / n, 3), "script_ok": round(ok / n, 3)}
cases 的格式是 [{"messages": [...], "intent": "reject"}, ...]。跑完你会得到一张属于自己的对比表,用它说服老板,比任何榜单都有力。
⚠️ 评测要在 和生产相同的地域、相同的网络 下跑,至少跑两个时段(如上午 10 点和晚上 8 点),高峰期首字延迟可能明显变化。端到端语音模型无法直接套用文本脚本,需录制音频测试集单独评测。
怎么看结果(经验门槛,按业务调整):
| 指标 | 主对话模型及格线 | 不达标意味着 |
|---|---|---|
| 首字延迟 P90 | ≤ 500ms | 客户会感觉"卡" |
| 意图准确率 | ≥ 90% | 流程走错,转化损失 |
| 话术合规率 | ≥ 98% | 有投诉和合规风险 |
四、第二步:分层路由,让每个请求找到对的模型
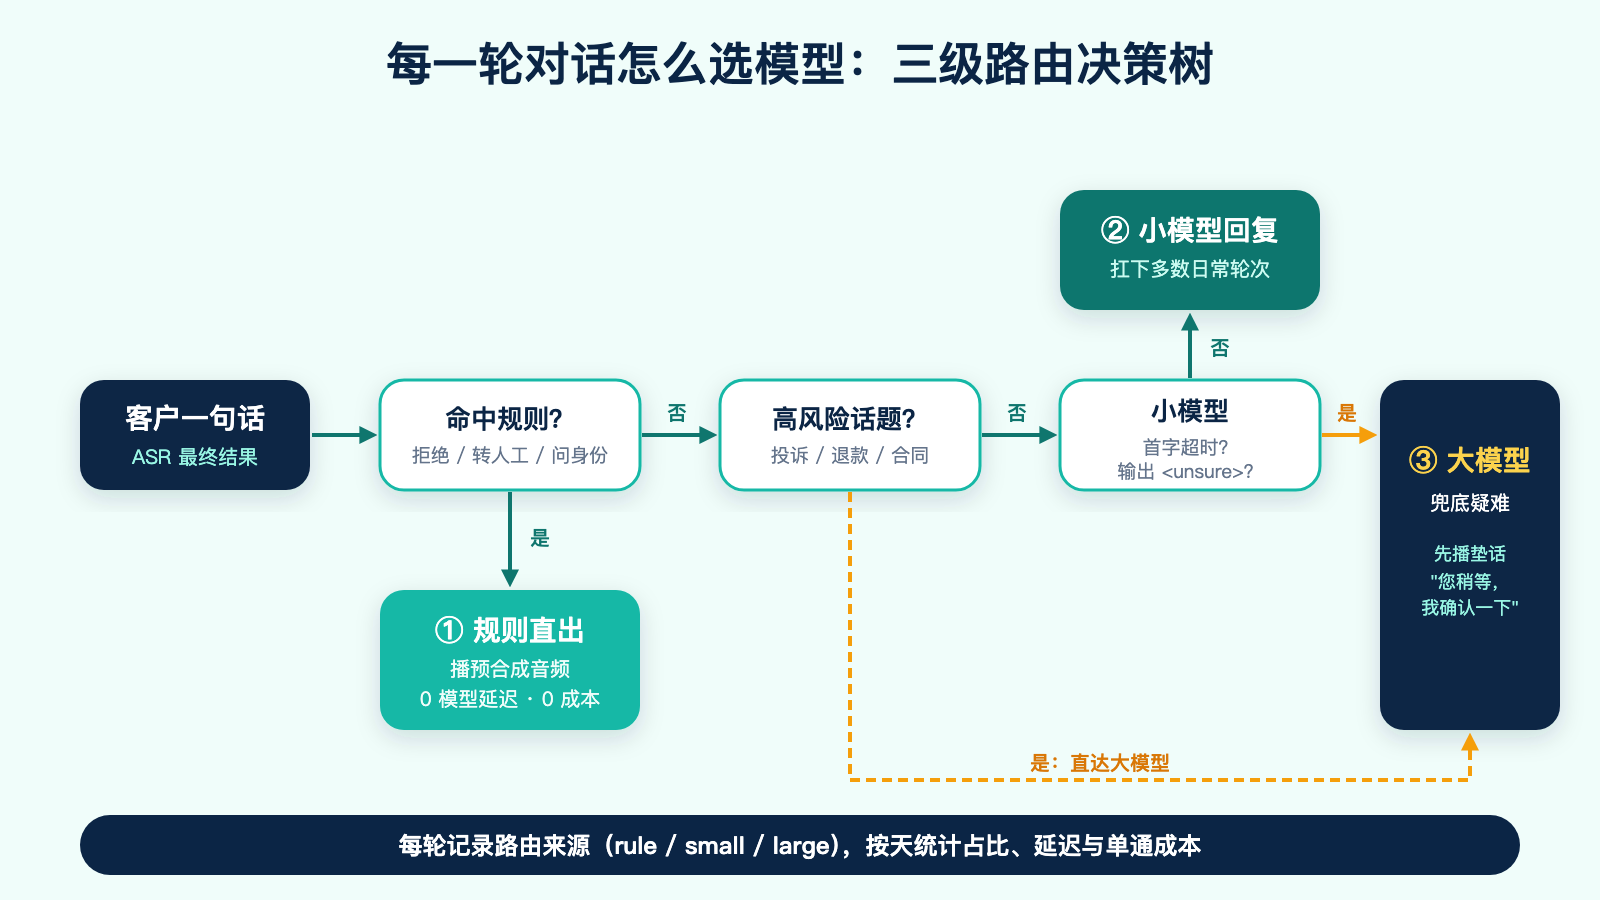
评测做完,你大概率会发现:小模型在 70% 的简单轮次上和大模型几乎没差别,剩下 30% 才是差距所在。 那就别二选一,按难度分流:
4.1 三级路由:规则 → 小模型 → 大模型
- 第一级:规则直出。"不需要""转人工"这类高频确定性意图,用正则 / 关键词直接回预合成话术,零模型延迟、零成本;
- 第二级:小模型主对话。设置超时,并约定"拿不准就输出
<unsure>"; - 第三级:大模型兜底。投诉、退款、合同类高风险问题直达,小模型超时或拿不准时也升级。
import re
import concurrent.futures as cf

# 第一级规则:(匹配规则, 意图, 预设回复),回复可对应预合成好的 8k wav
FAST_RULES = [
    (re.compile(r"^(不需要|不用了|没兴趣|别打了)"), "reject", "好的,打扰您了,祝您生活愉快。"),
    (re.compile(r"(转人工|找人工|真人)"), "to_agent", "好的,马上为您转接人工客服。"),
]
HARD_HINT = re.compile(r"(投诉|退款|合同|赔偿|律师|为什么.*扣)")   # 高风险话题直达大模型
_pool = cf.ThreadPoolExecutor(max_workers=32)                     # 全局复用线程池

def route(user_text: str, history: list, small, large, small_timeout=1.2):
    """三级路由:规则直出 → 小模型 → 大模型兜底;返回 (来源, 回复)。
    small / large 为调用对应模型并返回回复文本的函数。"""
    text = user_text.strip()
    for pattern, intent, reply in FAST_RULES:          # 第一级:确定性意图,不调模型
        if pattern.search(text):
            return f"rule:{intent}", reply
    msgs = history + [{"role": "user", "content": text}]
    if HARD_HINT.search(text):                         # 复杂 / 高风险问题直接上大模型
        return "large", large(msgs)
    fut = _pool.submit(small, msgs)                    # 第二级:小模型,带超时保护
    try:
        reply = fut.result(timeout=small_timeout)
        if reply and "<unsure>" not in reply:          # 约定小模型拿不准时输出 <unsure>
            return "small", reply
    except cf.TimeoutError:
        pass                                           # 超时直接升级,不等小模型
    return "large", large(msgs)                        # 第三级:大模型兜底
小模型系统提示词里加一句约定即可:
如果客户的问题涉及你不确定的信息(价格政策、合同条款、与其他产品的比较、投诉处理),
不要猜测,只输出 <unsure>,系统会转给更专业的同事处理。
💡 生产环境中,上面的
small / large应换成 流式 调用,并把"超时"定义为 首字超时(如 600ms 没出第一个字就升级),配合上一篇的"按标点切句"边生成边播。升级到大模型时,先uuid_broadcast <uuid> /path/to/wait_8k.wav aleg播一句预合成垫话"您稍等,我确认一下",避免冷场。
4.2 端到端语音模型放在哪?
端到端方案不是不能用,而是要 放在适合它的位置:
| 适合 | 不适合 |
|---|---|
| 满意度回访、活动邀约、陪练、情感陪伴等"聊得顺最重要"的场景 | 金融、保险、医疗等有强制告知语、话术需逐字审核的场景 |
| 流程分支少、无需频繁查业务系统 | 需要多次调用工具查订单、改预约 |
| 能接受按音频时长计费 | 对单通成本极度敏感的大批量外呼 |
如果一定要在强监管场景用端到端模型,至少做到两点:合规告知语用预录音频固定播放,不交给模型生成;开启平台提供的文本转写回传(如果所用模型支持),用于落库质检。
五、第三步:算清楚"一通电话多少钱"
很多人算成本只算"每轮输入 + 输出",漏了一个大头:每一轮都要把完整对话历史重新发给模型,输入 token 是随轮次累加的。
def call_cost(turns, in_tokens_per_turn, out_tokens_per_turn, price_in, price_out,
              cache_ratio=0.0, price_cache=None, asr_per_min=0.0, tts_per_10k_chars=0.0,
              minutes=1.5, chars_per_turn=30):
    """估算单通电话成本(元)。
    价格单位:LLM 元/百万 tokens;ASR 元/分钟;TTS 元/万字。
    in_tokens_per_turn:每轮新增的输入 token(系统提示词按首轮计入,可自行调整);
    cache_ratio:输入中命中前缀缓存的比例,price_cache 为缓存命中单价。"""
    total_in = sum(in_tokens_per_turn * (i + 1) for i in range(turns))  # 历史逐轮累加
    cached = total_in * cache_ratio
    price_cache = price_in if price_cache is None else price_cache
    llm = ((total_in - cached) * price_in + cached * price_cache
           + turns * out_tokens_per_turn * price_out) / 1e6
    asr = minutes * asr_per_min
    tts = turns * chars_per_turn / 1e4 * tts_per_10k_chars
    return {"llm": round(llm, 4), "asr": round(asr, 4), "tts": round(tts, 4),
            "total": round(llm + asr + tts, 4), "total_in_tokens": total_in}

# 价格均为占位示例,请替换为你所用平台的官方价格
print(call_cost(turns=8, in_tokens_per_turn=600, out_tokens_per_turn=40, price_in=2, price_out=8))
print(call_cost(turns=8, in_tokens_per_turn=600, out_tokens_per_turn=40, price_in=2, price_out=8,
                cache_ratio=0.6, price_cache=0.5))
用占位价格跑出来的结果:8 轮对话累计输入 21600 tokens(不是 4800),LLM 部分约 0.046 元;开启前缀缓存、命中 60% 后降到约 0.026 元,直接省下四成多。
三个省钱抓手:
- 固定内容放最前面:系统提示词、话术库、产品资料不变,放在消息最前面,最大化前缀缓存命中;
- 历史裁剪:超过 6 轮后,把早期对话压缩成一句摘要,而不是全量带上;
- 规则层分流:第一级规则每命中一次,就省掉一次模型调用和一次 TTS 合成。
⚠️ 端到端语音模型通常按音频时长或音频 token 计费,与文本模型口径不同,请按平台官方计费说明单独测算,不要直接套用上面的公式。
六、上线验收清单
- 已用 ≥ 200 条自有真实对话完成候选模型评测,并保留评测报告;
- 主对话模型首字延迟 P90 ≤ 500ms、意图准确率 ≥ 90%、话术合规率 ≥ 98%;
- AI 服务端已抽象模型接口,切换模型 只改配置不改代码;
- 规则层覆盖拒绝、转人工、骂人、问身份等高频意图,命中直接播预合成音频;
- 小模型有首字超时与
<unsure>升级机制,升级时有垫话; - 每轮记录"路由来源(rule / small / large)",可按天统计占比和单通成本;
- 端到端方案(如使用):合规告知语固定播放,转写文本完整落库。
七、避坑指南
- 别用通用榜单替代业务评测:榜单第一的模型,在"电话里两句话说清楚"这件事上不一定第一。
- 别只测平均延迟:P90 才代表高峰期最不耐烦的那批客户,务必在业务高峰时段复测。
- 模型升级要回归:平台更新模型版本后,话术风格和意图判断可能变化,固定模型版本号,升级前重跑评测集。
- 合规先行:外呼必须使用合规号码资源,遵守呼叫时段与频次要求,客户明确拒绝后不再推销;通话录音和识别文本属于个人信息,按规定脱敏存储,未经授权不得用于训练模型。
写在最后
选模型这件事,本质上是在 聪明、速度、成本、可控 四者之间找平衡点。与其纠结"哪个模型最强",不如搭好 评测集 + 路由层 + 成本看板 这三件基础设施——有了它们,模型每季度怎么更新换代,你都能在一天之内做出有数据支撑的决策。
下期预告:微调还是提示词?AI 外呼话术控制的决策树与成本账。
📌 本文为「FreeSWITCH × AI」系列第 2 篇,专注 AI 智能呼叫的工程落地。你在用哪种方案?评测结果如何?欢迎留言交流,后续文章优先解答。
注:文中评分与延迟门槛为经验区间,价格为占位示例;各平台模型型号、能力与计费以官方文档为准,请以实测为准。