

一句话看懂本文:90% 的 AI 外呼团队不需要一上来就做微调。流程红线归代码状态机,动态业务归分阶段提示词,说话腔调与小模型降本才归微调。 先把 3000 字"一锅炖"提示词拆成"固定前缀 + 节点微指令",日有效接通稳定过几万通或小模型实在控不住时,再算账上微调。
一、问题现象:越改越乱的提示词,和烧钱不讨好的微调
上一篇我们聊了大、小模型与端到端语音模型的选型。真正进场调话术时,几乎每个团队都会在 "继续改提示词" 和 "干脆去微调(Fine-tuning)" 之间反复纠结,常见两种翻车现场:
- "屎山提示词"综合症:上线第一天系统提示词只有 300 字;每出一个客诉,运营就往里塞一条"禁止……注意……如果客户说 A 就回 B"。三个月后提示词膨胀到 3500 字——结果 首字延迟(TTFT)慢了半秒,输入 Token 账单翻了三倍,模型还顾头不顾尾,前面写的"每次只问一个问题",后面全忘了。
- "冲动微调"综合症:听说微调能让小模型变听话,立刻抽了 500 通历史录音转文字丢去跑 LoRA。花了一两周洗数据、租卡训练,上线一看:语气确实像真人坐席了,但 下个月活动价格从 199 改成 169,模型张口还是 199;而且微调模型走专属实例或溢价计费,低并发时段光空转租金就比以前调 API 还贵。
话术控制失灵,根源往往不是模型笨,而是 让提示词和微调干了它们不擅长的活。
二、原理拆解:状态机、提示词、RAG、微调各自管什么?
在电话外呼这种 强流程、低延迟、严合规 的工程场景里,控制 AI 说话其实有四把刀,每一把刀的能力边界完全不同:
| 控制手段 | 最擅长解决什么 | 坚决别让它干什么 | 修改生效速度 | 对响应延迟影响 |
|---|---|---|---|---|
| 代码状态机 + 固定录音 | 必播合规告知、拒绝两次必挂机、精确金额校验 | 开放式寒暄、灵活追问解答 | 秒级(改配置) | 零延迟 / 降低延迟 |
| 分阶段提示词(Prompt) | 当前节点任务、客户姓名/订单变量、短期活动规则 | 背诵几十页产品手册、硬控 100% 不出违禁词 | 秒级(热更新) | 随前缀长度增加(可用缓存抵消) |
| 知识检索(RAG) | 上百个商品 FAQ、门店地址、售后政策按需调取 | 控制语气长短、决定对话下一步往哪走 | 分钟级(更新库) | 增加 50~200ms 检索耗时 |
| 监督微调(SFT / LoRA) | 口语化短句习惯、方言/行业黑话理解、压缩长指令、固定 JSON 输出结构 | 记住频繁变动的优惠价格、替代程序护栏 | 天~周级(重训) | 输入更短,TTFT 更快 |
核心原理只有两条:
- 提示词改变的是"上下文注意力",微调改变的是"模型行为习惯"。价格、日期、客户姓名这种每通电话都在变的事实,必须走提示词槽位或工具查询;而"别说书面套话、每次不超两句、遇到犹豫先共情再给方案"这种长期不变的说话方式,才是微调的主场。
- 任何概率模型都不能替代确定性护栏。无论提示词写十遍"严禁承诺稳赚",还是微调洗一万条样本,只要走生成式输出,理论上就有极小概率越界。合规红线必须在 FreeSWITCH 放音控制和服务端正则/状态机里兜底。
三、五步决策树:什么时候改提示词,什么时候上微调?
拿到一个外呼业务需求,建议严格按下面的五步决策树往下走,不要跳步:
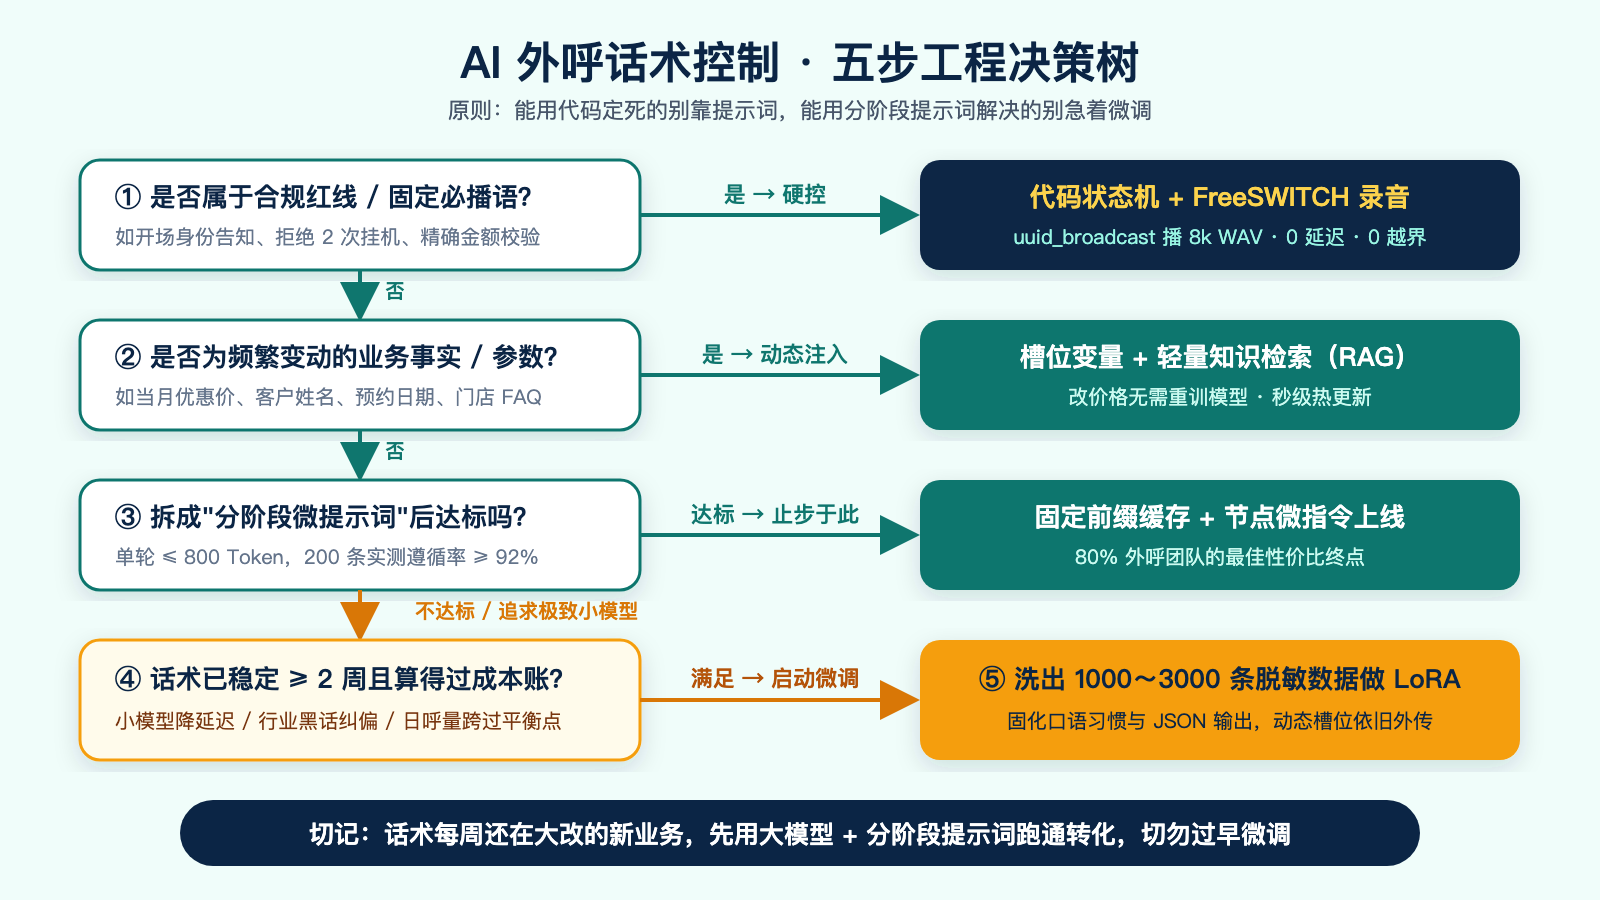
第一步:先把确定性节点剥离给 FreeSWITCH + 状态机
首句合规身份告知、固定结束语、明确拒绝后的道别,根本不需要每次让大模型现编。直接预合成 8k 采样率的 WAV 文件,在 FreeSWITCH 侧通过 ESL 下发播放,既 0 生成延迟,又 100% 一字不差。
在 ESL(Outbound 或 Inbound 模式)中,建议每切换一个对话阶段,同步写入通道变量(Channel Variable),方便通话结束后在 FreeSWITCH CDR(话单)里统计各阶段的挂机漏斗:
# 记录当前话术阶段到通道变量,CDR 落盘时可直接关联分析哪个节点挂机最多
uuid_setvar <uuid> ai_stage survey

# 命中开场白或固定合规结语时,直接播放预合成 8k 录音,不走大模型
uuid_broadcast <uuid> /var/lib/freeswitch/recordings/ai_tpl/closing_polite_8k.wav aleg
💡 如果需要在话单中自动保留自定义变量,可在
autoload_configs/cdr_csv.conf.xml(或xml_cdr对应模板)中引用${ai_stage},具体配置项以所用 FreeSWITCH 版本文档为准。
第二步:把"一锅炖"长提示词拆成"固定底稿 + 节点微指令"
很多同行觉得"提示词不好用",是因为把 开场、核身、挖掘需求、报价、异议处理、促成、收尾 7 个阶段的规则全塞进同一个 System Prompt。模型在"开场"阶段看到了"报价异议"的话术,就容易提前抢跑。
正确做法是 状态机驱动的分阶段提示词,同时把一字不改的全局规则放在第一条消息,吃满国内主流平台(如 DeepSeek、通义千问、豆包、混元等)的 上下文前缀缓存(Context Caching):
# 全局固定底稿:保持字节级不变,放在 messages[0] 以触发模型平台前缀缓存
BASE_SYSTEM_PROMPT = (
    "你是【安信家政】的回访客服【小安】,负责老客户满意度回访与季卡告知。\n"
    "全局说话铁律:\n"
    "1. 每次回复不超2句话,首句不超15字,纯口语,禁书面词与列表符号;\n"
    "2. 数字用口语读法(如“一百九十九块”),严禁承诺未授权折扣;\n"
    "3. 客户累计明确拒绝2次,或表达反感/要求勿扰,立即礼貌道别并输出挂机标记。"
)

# 各节点微指令:每轮只注入当前所在阶段的 100 字规则,模型注意力更集中
STAGE_PROMPTS = {
    "opening": "当前阶段:核实身份与开场。确认对方是否为【{customer_name}】,说明来意是上次保洁服务回访,询问现在是否方便聊两句。",
    "survey": "当前阶段:服务回访。询问客户对【{last_service_date}】上门保洁是否满意;若客户提意见,先诚恳致歉并记录,不推诿、不推销。",
    "offer": "当前阶段:权益告知。仅在客户满意时介绍老客专享【{offer_desc}】,询问是否需要把详情发到手机短信,不强行催单。",
    "closing": "当前阶段:礼貌收尾。简短感谢客户接听,祝生活愉快,不再追问任何新问题。",
}

def build_turn_messages(stage: str, slots: dict, history: list) -> list:
    """组装单轮对话消息:固定前缀放第一条命中缓存,动态节点指令放末尾增强遵循度"""
    stage_rule = STAGE_PROMPTS[stage].format(**slots)
    return [
        {"role": "system", "content": BASE_SYSTEM_PROMPT},
        *history[-6:],  # 滑动窗口只保留最近 3 轮(6 条),防止长通话延迟爬升
        {"role": "system", "content": stage_rule},
    ]
为什么把 stage_rule 放在末尾? 大模型普遍存在"近因效应"(对靠近输入末尾的指令遵循度更高),而开头保持静止又能命中缓存省钱提速——一头省钱,一头提准。
第三步:只有同时满足以下条件,才进入微调立项
当你做完了上面两步,用 200 条真实测试集跑分后,出现以下 任一明确信号 且业务话术已稳定运行至少 2~4 周,再启动微调:
- 小模型"听不懂规矩",大模型又太慢太贵:想用 7B~14B 级小模型把首字延迟压进 250ms,但零样本下小模型总带书面腔,或者无法稳定同时输出"回复文本 + 意图分类 JSON";
- 行业表达高度垂直:例如催收合规话术、医疗随访术语、车险续保专有险种简称,通用提示词怎么解释都有歧义;
- 日呼量迈过成本平衡点:高频外呼场景下,把每轮几百字的规则与 Few-shot 示例内化进权重,省下的输入 Token 费用足以覆盖微调与部署开销。
四、算清成本账:日呼多少通,微调才真正省钱?
很多技术团队向老板申请微调预算时只算"训练一次几百块",却漏掉了两笔真正的大头:人工洗数据的隐性人力成本(通常整理 2000 条高质量多轮对话需投入数人日),以及 微调后的在线推理计费模式变化。
目前微调模型上线主要有两条路径:
- 路径 1:云平台托管 LoRA 按 Token 计费。免运维,但不少平台的微调后推理单价是同规格公共底座的 1.5~2.5 倍(具体以各厂商官网定价为准)。如果你原本已经用了"分阶段提示词 + 前缀缓存",换成同档位托管 LoRA 往往 不省钱反而更贵——除非你是用"微调后的轻量模型"去替换原本昂贵的"旗舰大模型"。
- 路径 2:自建或租用独占 GPU 实例(vLLM / SGLang 部署)。固定月租(例如单卡推理实例经验区间约 3000~5000 元/月,视卡型与云厂商而定),边际 Token 成本近似为 0,但必须考虑 外呼集中在白天 9:00–12:00、14:00–18:00 的波峰并发 与夜间空置浪费。
下面这段计算器可以直接把你们公司的真实单价填进去算回本周期:
from dataclasses import dataclass

@dataclass
class CostScenario:
    """大模型推理与微调成本测算参数(单位:人民币元,经验示例值,请按实际合同价替换)"""
    daily_calls: int               # 日均有效接通数(进入多轮对话的通话)
    turns_per_call: float = 4.5    # 单通平均交互轮次
    raw_in_tokens: int = 2200      # 方案A:粗放长提示词每轮输入 token
    opt_cached_tokens: int = 320   # 方案B:分阶段提示词命中缓存的输入 token
    opt_uncached_tokens: int = 430 # 方案B:分阶段提示词未命中缓存的动态 token
    ft_in_tokens: int = 280        # 方案C:微调后每轮仅传短系统头+近期对话
    out_tokens: int = 45           # 单轮平均输出 token(约 30 个汉字)
    api_in_price: float = 1.0      # 公共API普通输入单价(元 / 百万 token)
    api_cache_price: float = 0.2   # 公共API缓存命中单价(元 / 百万 token)
    api_out_price: float = 3.0     # 公共API输出单价(元 / 百万 token)
    ft_fixed_monthly: float = 3500.0  # 独占GPU推理实例月租(元 / 月)
    ft_oneoff_cost: float = 6000.0    # 一次性标注清洗 + 训练调优综合成本

def evaluate_monthly_cost(cfg: CostScenario) -> dict:
    """对比三种方案的月度(30天)模型推理成本与微调回本月数"""
    monthly_turns = cfg.daily_calls * cfg.turns_per_call * 30
    m = 1_000_000
    cost_raw = monthly_turns * (cfg.raw_in_tokens * cfg.api_in_price + cfg.out_tokens * cfg.api_out_price) / m
    cost_opt = monthly_turns * (
        cfg.opt_cached_tokens * cfg.api_cache_price
        + cfg.opt_uncached_tokens * cfg.api_in_price
        + cfg.out_tokens * cfg.api_out_price
    ) / m
    cost_ft = cfg.ft_fixed_monthly
    saving = cost_opt - cost_ft
    payback = round(cfg.ft_oneoff_cost / saving, 1) if saving > 0 else None
    return {
        "daily_calls": cfg.daily_calls,
        "粗放长提示词_月费": round(cost_raw),
        "分阶段+缓存_月费": round(cost_opt),
        "独占实例微调_月费": round(cost_ft),
        "相比优化后回本月数": payback,
    }
按上述经验参数跑出来的月度账单对比一目了然:
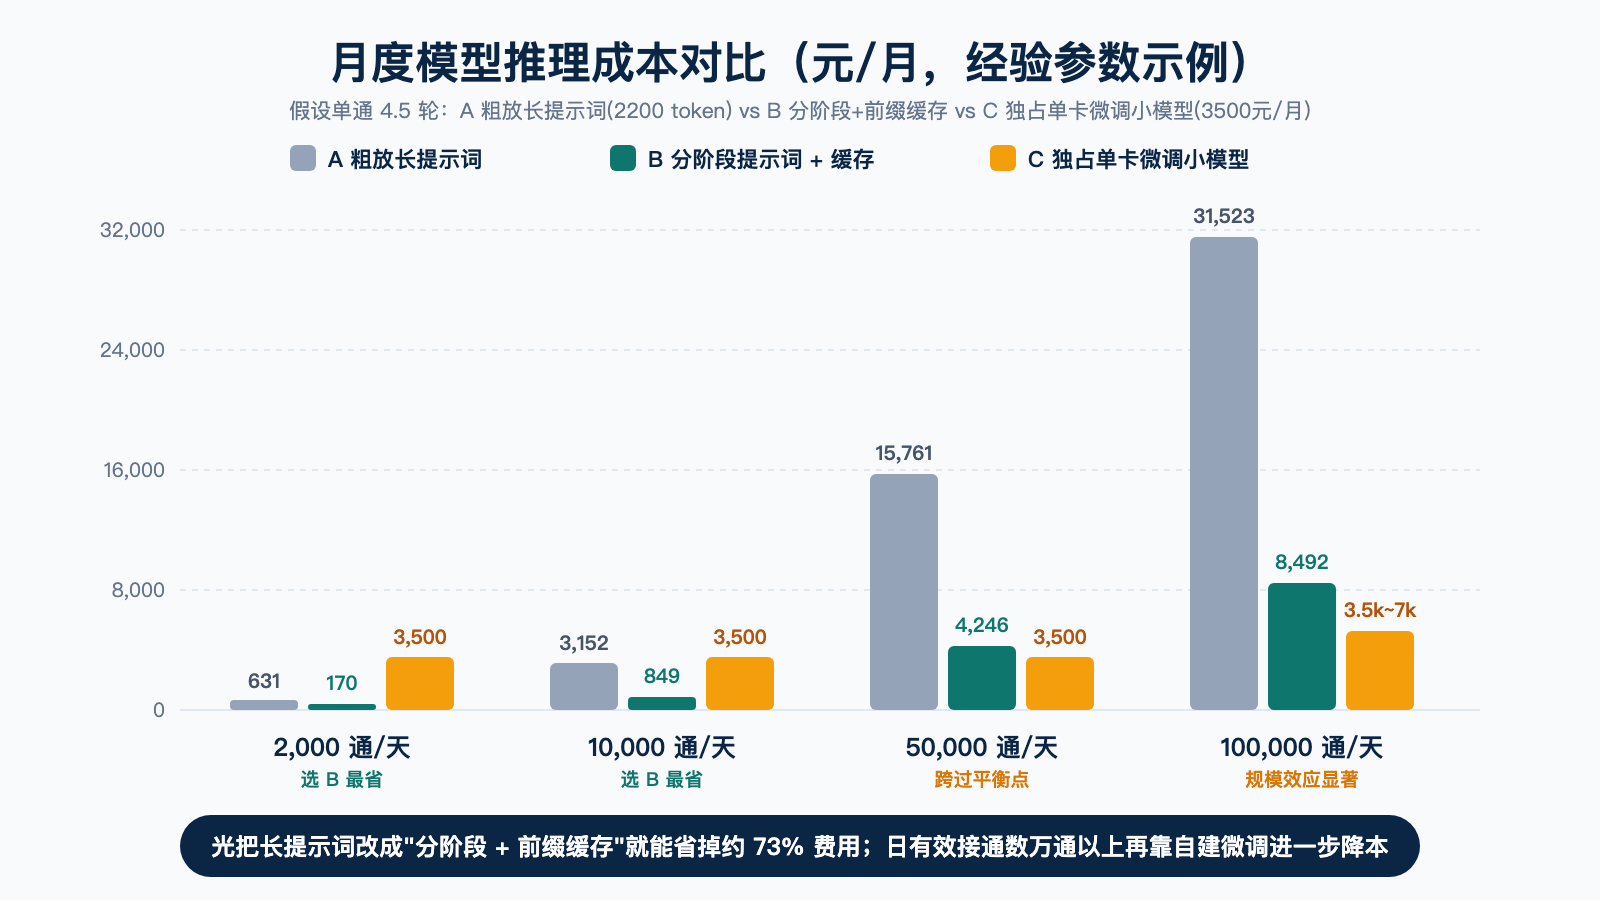
| 日有效接通数 | 方案 A:粗放长提示词 | 方案 B:分阶段提示词 + 缓存 | 方案 C:微调小模型(独占单卡示例) | 财务最优选择 |
|---|---|---|---|---|
| 2,000 通/天 | ≈ 631 元/月 | ≈ 170 元/月 | ≈ 3,500 元/月 | 选方案 B,微调纯属倒贴 |
| 10,000 通/天 | ≈ 3,152 元/月 | ≈ 849 元/月 | ≈ 3,500 元/月 | 选方案 B,除非质量必须微调 |
| 50,000 通/天 | ≈ 15,761 元/月 | ≈ 4,246 元/月 | ≈ 3,500 元/月 | 跨过平衡点,约 8 个月回本 |
| 100,000 通/天 | ≈ 31,523 元/月 | ≈ 8,492 元/月 | ≈ 3,500~7,000 元/月(视峰值扩容) | 规模效应显著,1~4 个月回本 |
⚠️ 算账提醒:表内数字为按示例单价推演的 模型层费用(不含线路费、ASR 与 TTS 费用)。若日呼 10 万通集中在 6 个小时内拨打,峰值并发可能需要 2 张及以上推理卡,务必按 峰值 QPS 压测后再核定实例数。
五、真要做微调:怎么把通话日志洗成干净的 SFT 数据?
一旦决定微调(例如基于 Qwen2.5 / Qwen3 系列用 LLaMA-Factory 训练 LoRA,或在阿里云百炼、火山方舟等平台提交在线微调任务),决定成败的不是学习率,而是训练数据干不干净。
呼叫中心做 SFT 最容易踩两个大坑:
- 把客户隐私训进模型权重:历史对话里包含真实手机号、身份证号、家庭住址,一旦未脱敏直接进训练集,不仅违反个人信息保护法规,模型还可能在别的通话里"背诵"出来;
- 把坐席或旧模型的坏习惯学进去:金牌坐席偶尔也会说超长句、口头禅,甚至擦边承诺,原样照搬会让微调模型染上同样毛病。
下面这段数据清洗脚本可直接对接你的通话明细库,完成 正样本筛选、隐私脱敏、红线过滤与标准 JSONL 导出:
import json, re

PHONE_RE = re.compile(r"(?<!\d)1[3-9]\d{9}(?!\d)")
IDCARD_RE = re.compile(r"(?<!\d)\d{17}[\dXx](?!\d)")
BANNED_RE = re.compile(r"保证|稳赚|百分之百|绝对最低|最后一天")

def mask_pii(text: str) -> str:
    """对对话文本中的手机号与身份证号脱敏替换,防止隐私信息进入微调权重"""
    text = PHONE_RE.sub("<PHONE>", text)
    text = IDCARD_RE.sub("<IDCARD>", text)
    return text

def convert_call_logs_to_sft(records: list, short_sys_prompt: str) -> list:
    """筛选高质量通话记录,脱敏并校验单轮回复合规性后,转为标准 SFT messages 格式"""
    dataset = []
    for rec in records:
        # 1. 只保留业务转化成功/回访完成,且无投诉、无异常挂断的样本
        if not rec.get("qualified") or rec.get("complained"):
            continue
        turns = rec.get("turns", [])
        if len(turns) < 4:
            continue

        messages = [{"role": "system", "content": short_sys_prompt}]
        clean = True
        for t in turns:
            role = "user" if t["speaker"] == "customer" else "assistant"
            content = mask_pii(t["text"].strip())
            if role == "assistant":
                # 2. 剔除单句超 45 字或含营销红线词的轮次,宁缺毋滥
                if len(content) > 45 or BANNED_RE.search(content):
                    clean = False
                    break
            messages.append({"role": role, "content": content})
        if clean:
            dataset.append({"messages": messages})
    return dataset

# 导出为国内外主流微调平台与 LLaMA-Factory 通用的 JSONL 文件
def dump_jsonl(dataset: list, out_path: str):
    """将清洗后的多轮样本逐行写入 JSONL 文件"""
    with open(out_path, "w", encoding="utf-8") as f:
        for row in dataset:
            f.write(json.dumps(row, ensure_ascii=False) + "\n")
训练数据配比经验区间(通常 1,000~3,000 条精选多轮对话 就足够训出明显效果,贪多塞入几万条低质录音反而会导致性能退化):
- 60% 标准正向全流程:覆盖各节点的自然口语问答;
- 25% 高频异议与打断接续:"太贵了""在忙待会说""发短信就行"以及 ASR 轻微同音错字下的鲁棒回复;
- 15% 拒识与红线防御样本:面对诱导承诺、索要他人隐私或连续两次拒绝时,干脆利落地合规收尾。
💡 关键细节:训练时的
short_sys_prompt必须和上线推理时传的 System Prompt 保持一致,并且仍然保留{offer_desc}等动态业务槽位在用户或节点提示词中传入——让微调固化"怎么说",让槽位传入"说什么优惠",这样下次改价格就完全不用重新训练!
六、上线验收清单
无论最终选了"分阶段提示词"还是"LoRA 微调",切流量前逐项打钩:
- 合规必播语、二次拒绝挂机、金额数字核对已由 代码状态机 + FreeSWITCH 预合成录音 硬控,不依赖模型自觉;
- 系统提示词已拆分为"固定前缀(放在
messages[0]命中缓存)+ 当前阶段微指令",单轮输入控制在 800 Token 以内; - ESL 控制层已在阶段切换时写入
ai_stage等通道变量,支持按节点统计挂机率; - 若采用微调,训练集中所有手机号、身份证号、姓名住址等个人信息已完成正则 + 人工双重脱敏;
- 动态价格、日期、活动政策通过运行时槽位注入,修改活动价格无需重新训练模型;
- 已使用同一套 200 条离线测试集 + 10% 线上灰度流量对比:首字延迟 P90、红线违例率(必须为 0)、意图完成率均优于旧版。
七、避坑指南
- 别在业务探索期做微调:话术每周还在大改的新业务,微调就是无底洞。先用大模型 + 分阶段提示词跑通转化漏斗,等话术定型后再用大模型的高分线上日志"蒸馏"微调小模型,事半功倍。
- 警惕"灾难性遗忘":LoRA 秩(
lora_rank)和训练轮数(epochs,通常 2~3 轮即可,具体以框架文档与验证集 Loss 为准)设得过大,小模型容易变成"复读机",客户稍微问一句闲聊就卡壳。训练集中适当混入 5%~10% 礼貌拉回主线的闲聊样本。 - 前缀缓存一旦破功,账单翻倍:不少人把
当前时间:2026-11-20 10:05:23拼在BASE_SYSTEM_PROMPT第一行,导致每一通电话的前缀都不一样,缓存命中率直接归零!动态变量一律往后放。 - 合规底线不可触碰:外呼业务必须使用合规申请的通信线路与号码资源,严格遵守外呼时段与频次限制,客户明确表示拒绝或要求勿扰后必须立即停止拨打并加入禁呼名单;用于评测与微调的通话录音和转写文本须按《个人信息保护法》要求加密存储、最小化授权并彻底脱敏。
写在最后
工程架构里最划算的优化,往往是 "不做没必要的重活"。把状态机、前缀缓存和分阶段提示词这三招用透,足以解决八成以上 AI 外呼团队的延迟、跑偏和账单焦虑;而当你真正手握几万日活通话、准备用微调小模型榨出极致性价比时,干净脱敏的数据流水线才是你的核心护城河。
下期预告:很多刚入行的朋友问,如果从零开始搭一套能跑通的电话机器人,最少需要哪几个组件?下一篇我们拆解 《从零搭建 AI 智能呼叫:FreeSWITCH + ESL + ASR + LLM + TTS 最小可用架构》,敬请期待。
📌 本文为「FreeSWITCH × AI」系列第 3 篇,专注 AI 智能呼叫的工程落地。你们团队目前在用纯提示词还是微调模型?欢迎评论区聊聊踩过的坑。
注:文中模型单价、GPU 实例月租与耗时数据为常见工程经验区间,仅作算账方法演示;各云厂商及模型平台的缓存规则、微调计费与模块参数请以最新官方文档为准。