

一句话看懂本文:AI 外呼"慢",八成不是模型慢,而是 断句等太久 + 链路串行。先埋点量化,再把"等说完 → 识别 → 生成 → 合成 → 播放"改成 全程流式、边生成边播,再配合打断与垫话,1 秒内响应完全可以做到。
一、你的 AI 外呼是不是也这样?
做过 AI 外呼 / 语音机器人的同行,大概率被这几句吐槽过:
- "我说完了,它愣了两三秒才回话,我以为掉线了";
- "机器人说话慢吞吞的,一句话绕半天";
- "我都说'不需要'了,它还在那念";
- 接通前 5 秒的挂机率居高不下。
人与人打电话,轮次切换的间隔通常只有几百毫秒。超过 1.5 秒,对方就会明显感觉"卡";超过 2.5 秒,很多人会直接挂断。 所以延迟不是体验问题,是 接通率和转化率问题。
二、先算账:延迟到底花在哪?
一次"客户说完 → AI 开口"的完整链路如下:
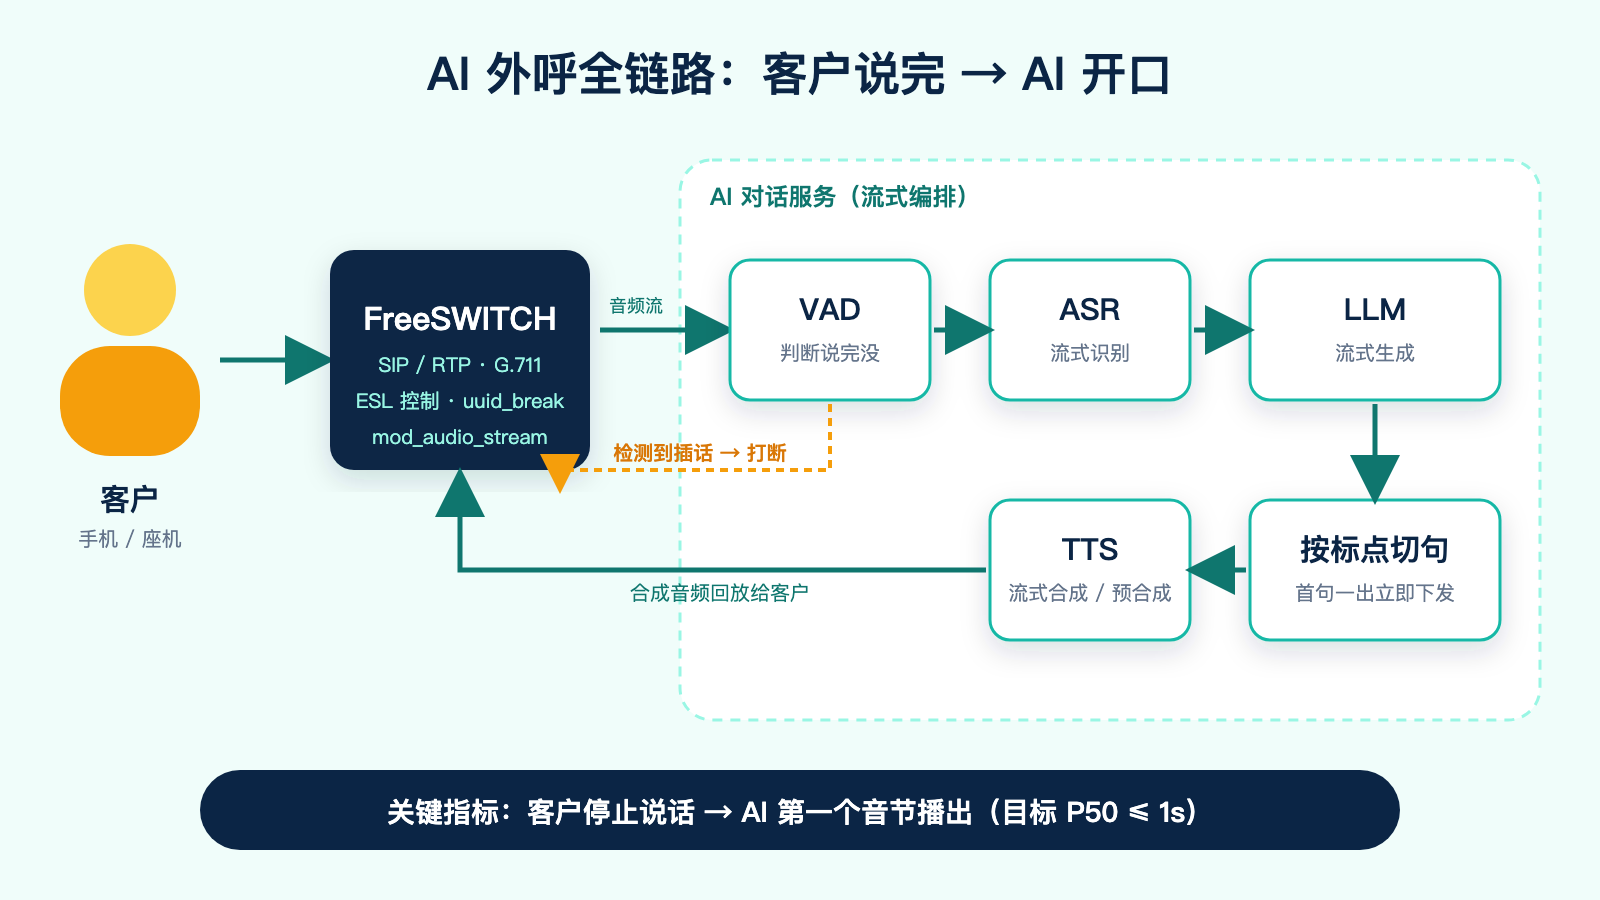
把每个环节的耗时拆开(以下为常见经验区间,具体取决于你的厂商、网络和部署方式):
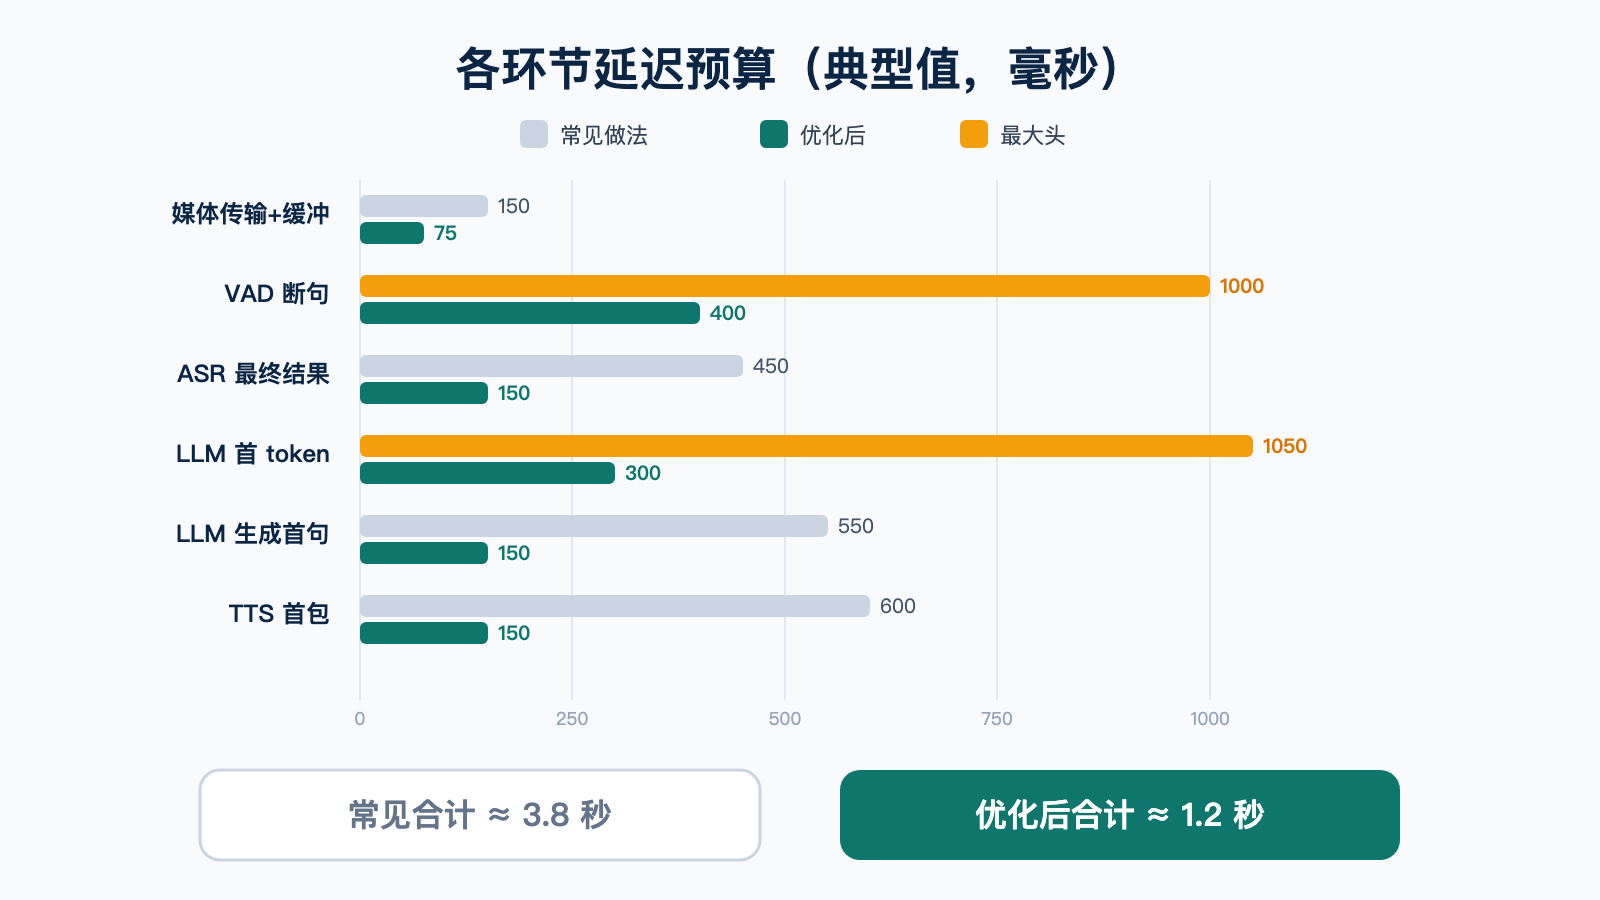
| 环节 | 常见做法耗时 | 优化后可达 | 优化关键 |
|---|---|---|---|
| 媒体传输 + 缓冲 | 100~200ms | 50~100ms | 就近部署、抖动缓冲别开太大 |
| VAD 断句(等客户说完) | 800~1200ms | 300~500ms | 静音阈值 + 语义判断 |
| ASR 出最终结果 | 300~600ms | 100~200ms | 流式识别,复用中间结果 |
| LLM 首 token | 600~1500ms | 200~400ms | 模型选型、就近、缓存、长连接 |
| LLM 生成首句 | 300~800ms | 100~200ms | 首句要短,按标点切句 |
| TTS 首包 | 400~800ms | 100~200ms | 流式合成、常用话术预合成 |
| 合计 | 2.5~5 秒 | 0.8~1.5 秒 |
结论很明确:最大的头是"断句"和"串行"。很多系统的做法是:录一段音 → 判断说完 → 整段送识别 → 整段送大模型 → 整段送合成 → 播放。每一步都要等上一步 全部 完成,延迟自然叠到 3 秒以上。
三、第一步:埋点,别凭感觉调
优化之前,先给每一通电话的每一个轮次打上时间戳。下面这段 Python 可以直接放进你的对话服务里:
import time, json, logging

class TurnTimer:
    """记录一个对话轮次中各环节的时间点(单位:毫秒,以客户停止说话为 0 点)"""
    def __init__(self, call_id: str, turn: int):
        self.call_id, self.turn = call_id, turn
        self.t0 = None
        self.marks = {}

    def speech_end(self):
        """VAD 判定客户说完时调用,作为本轮计时起点"""
        self.t0 = time.perf_counter()

    def mark(self, name: str):
        """在关键节点调用:asr_final / llm_first_token / first_sentence / tts_first_packet / play_start"""
        if self.t0 is not None and name not in self.marks:
            self.marks[name] = round((time.perf_counter() - self.t0) * 1000)

    def dump(self):
        """本轮结束时输出一行 JSON 日志,方便后续统计 P50 / P90"""
        logging.info(json.dumps({"call": self.call_id, "turn": self.turn, **self.marks}))
上线跑一天,统计 play_start 的 P50 和 P90(也就是"客户说完到 AI 出声"),再看哪个环节占比最大,先优化最大的那个。
💡 只看平均值会被误导。P90 才代表"十个客户里最不耐烦的那一个"的体验。
四、8 个立竿见影的优化手段
① 全链路流式:别再"录完再识别"
FreeSWITCH 侧把通话音频 实时 推给你的 AI 服务,常见三种方式:
| 方式 | 说明 | 适用 |
|---|---|---|
mod_audio_stream(社区模块) | 通过 WebSocket 实时推送通话音频帧 | 自研 AI 服务,最灵活 |
mod_unimrcp + MRCP Server | 走标准 MRCP 协议对接 ASR/TTS | 已采购国内厂商 MRCP 方案 |
record 录文件后识别 | 录完一段再送识别 | ❌ 延迟最大,只适合质检 |
以 mod_audio_stream 为例,拨号计划里接通后交给你的 ESL 程序控制:
<extension name="ai_outbound">
  <condition field="destination_number" expression="^ai_(.+)$">
    <action application="answer"/>
    <!-- 交给外部 ESL 程序(outbound 模式)控制整通电话 -->
    <action application="socket" data="127.0.0.1:8040 async full"/>
  </condition>
</extension>
ESL 程序拿到通道 UUID 后,开启音频流:
uuid_audio_stream <uuid> start ws://127.0.0.1:8080/asr mono 8k
⚠️
mod_audio_stream为第三方模块,不同分支的参数与回放能力有差异,请以你所用版本的 README 为准。
采样率小技巧:电话信道本身就是 8kHz,把 8k 硬升到 16k 喂给识别模型 并不会增加信息。优先选择厂商的 8k 电话信道模型,识别准确率往往更高,还省一次重采样。
② 断句:最大的延迟来源
VAD(语音活动检测)要等到"静音持续 N 毫秒"才认为客户说完。很多系统默认 800ms 甚至 1 秒以上——这部分延迟是白白等出来的。
建议做法:
- 静音阈值调到 300~500ms 作为基础值;
- 加一层语义判断:如果 ASR 中间结果已经是完整意图(如"不需要""好的""多少钱?"),可以提前结束本轮;
- 如果中间结果明显没说完(以"那个""就是""然后"结尾),自动延长 等待到 800ms;
- 不要一刀切调到 200ms 以下,否则客户一喘气 AI 就抢话,体验更差。
③ 大模型:首 token 才是关键指标
语音场景看的不是"生成完整回答要多久",而是 "第一个字多快出来"(TTFT)。
- 选型:对话轮次用 响应快的中小模型,复杂判断(如意向分级、总结)放到通话结束后异步做;
- 就近部署:FreeSWITCH、AI 服务、模型接口尽量 同地域,跨地域一来一回就是几十上百毫秒;
- 用好上下文缓存:把 固定不变的系统提示词放在最前面,变化的对话放后面。国内主流大模型平台大多支持前缀缓存,命中后首 token 更快、费用也更低;
- 保持长连接:HTTP 客户端全局复用,别每轮都重新建连 + TLS 握手;
- 限制输出:
max_tokens设在 100~150,temperature0.3 左右,回答更稳更短。
④ 边生成边合成:按标点切句
这是收益最大的一招:大模型吐出第一句,就立刻送 TTS 播放,后面的句子边生成边排队。
import re
from openai import OpenAI

# 国内主流大模型平台大多提供 OpenAI 兼容接口,替换 base_url / model 即可
client = OpenAI(base_url="https://你的模型平台/v1", api_key="sk-xxx")

FIRST_CUT = re.compile(r"[,,。!?!?;;]")   # 首句:遇到逗号就切,尽快出声
NEXT_CUT = re.compile(r"[。!?!?;;]")       # 后续:遇到句号再切,语调更自然

def stream_reply(messages, speak, timer):
    """流式调用大模型,按标点切句后逐句交给 speak()(TTS + 播放),并记录耗时"""
    buf, first = "", True
    stream = client.chat.completions.create(
        model="你的模型名", messages=messages,
        stream=True, max_tokens=120, temperature=0.3,
    )
    for chunk in stream:
        delta = (chunk.choices[0].delta.content or "") if chunk.choices else ""
        if not delta:
            continue
        timer.mark("llm_first_token")
        buf += delta
        while True:
            # 首句从第 4 个字起找标点,避免只播一个"好,"
            m = FIRST_CUT.search(buf, 3) if first else NEXT_CUT.search(buf)
            if not m:
                break
            sentence, buf = buf[:m.end()], buf[m.end():]
            if first:
                timer.mark("first_sentence")
                first = False
            speak(sentence)                 # 异步送 TTS,不要在这里阻塞等待播放结束
    if buf.strip():
        speak(buf)
⑤ TTS:流式合成 + 常用话术预合成
- 选择支持 流式返回 的 TTS 接口,拿到首包就开始播放;
- 开场白、确认语("好的""明白")、结束语、常见问题答复,提前合成好存成 8k wav,命中时直接
uuid_broadcast播放,0 合成延迟; - TTS 直接输出 8k 采样,避免 FreeSWITCH 再重采样。
⑥ "AI 说话慢":先分清是哪种慢
| 现象 | 真正原因 | 解决办法 |
|---|---|---|
| 开口前停顿很久 | 链路延迟 | 本文第 ①~⑤ 条 |
| 语速本身慢 | TTS 默认语速偏播音腔 | 语速参数调到 1.1~1.2 倍(多数厂商支持) |
| 一句话特别长 | 模型输出啰嗦、书面化 | 提示词约束:口语、短句、先说结论 |
第三种最常见,用提示词就能解决:
你是【XX公司】的电话客服【小安】,正在进行【会员续费回访】。
说话规则(必须遵守):
1. 每次回复不超过 2 句话,第一句不超过 15 个字;
2. 口语化,像真人打电话,不使用"您好,非常感谢您的耐心等待"等客套长句;
3. 先回答客户的问题,再推进下一步,一次只问一个问题;
4. 不使用书面符号、括号、列表、表情;数字用中文读法(如"二十九块九");
5. 客户明确拒绝两次,礼貌结束通话,不再推销。
⑦ 打断(Barge-in):客户一开口,AI 立刻闭嘴
AI 播放期间 继续监听客户音频,一旦检测到有效语音(VAD 持续 200ms 以上,或 ASR 出现有效文字):
- 立刻停止播放:
uuid_break <uuid> all
- 同时取消 正在进行的大模型流式请求和 TTS 请求,清空待播队列;
- 把"AI 已经说出口的部分"写入对话历史(没播出去的不要写),避免上下文错乱。
💡 可以设置"关键话术不可打断"(如合规告知语),其余话术一律允许打断。
⑧ 垫话:需要查数据时先"嗯"一声
当模型要调用工具(查订单、查余额)时,等待时间不可避免。这时立刻播放一句预合成的垫话:"好的,我帮您查一下",客户的等待感会大幅下降。
五、串行 vs 流式:效果对比
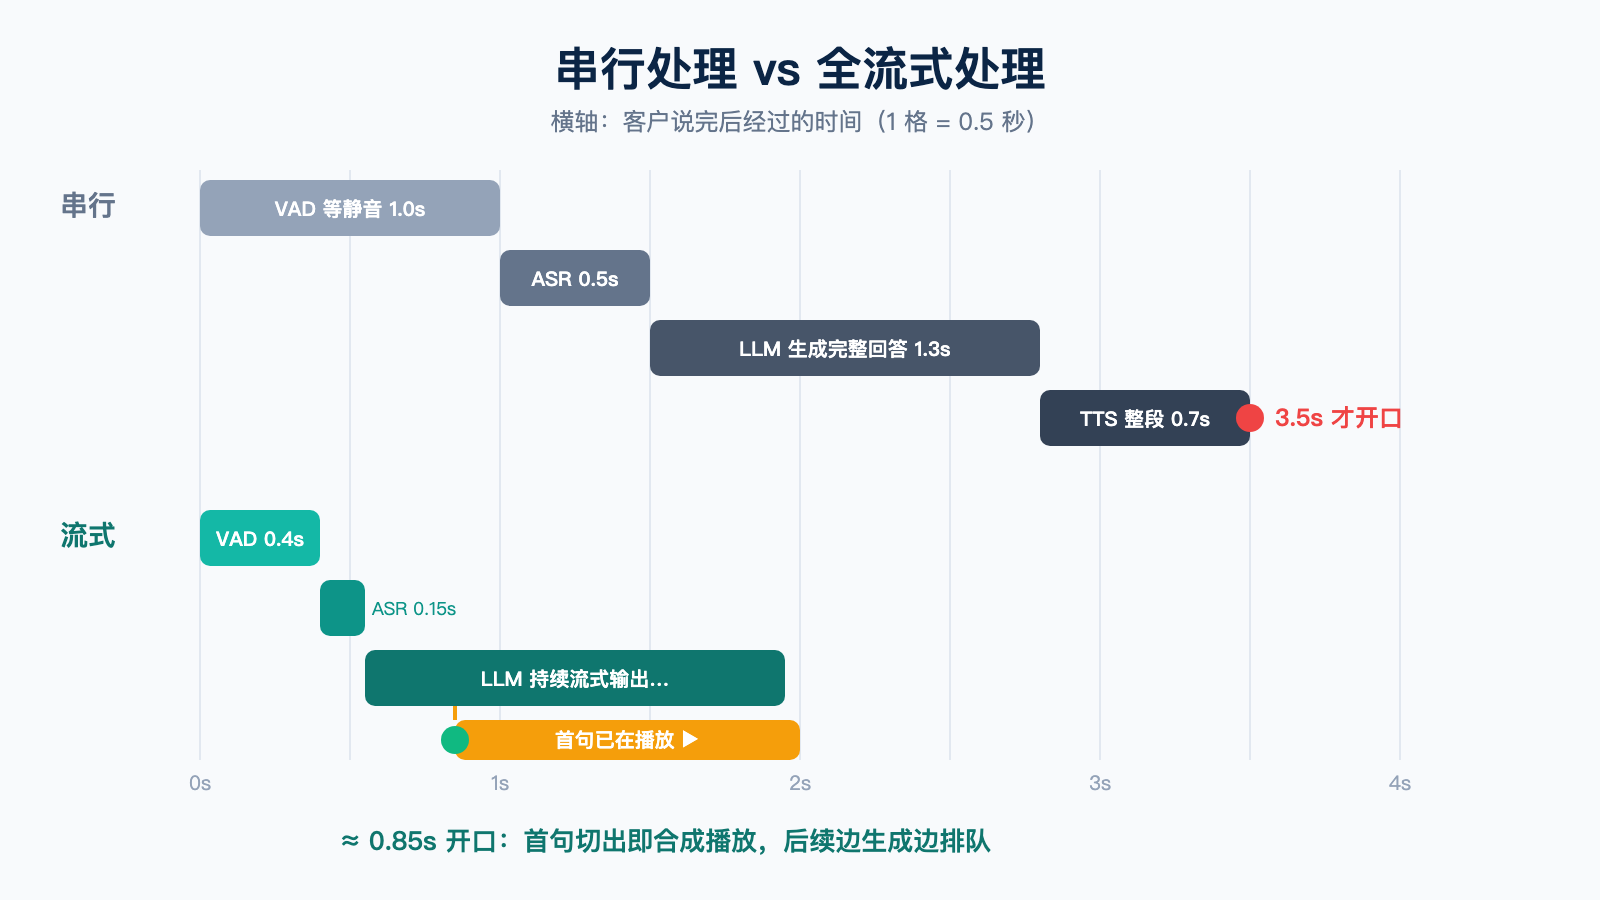
同样的模型、同样的 TTS,只是把"等上一步全部完成"改成"上一步一有输出就往下传",客户感知到的延迟就能下降一半以上。
六、上线验收清单
- 每轮都有
asr_final / llm_first_token / first_sentence / play_start埋点; -
play_start的 P50 ≤ 1 秒、P90 ≤ 1.5 秒; - 静音阈值 300~500ms,并有语义提前结束 / 自动延长逻辑;
- 大模型、TTS 全部流式,HTTP 长连接复用;
- 常用话术已预合成,命中率 ≥ 30%;
- 打断生效:客户开口后 300ms 内 AI 停止播放;
- 识别使用 8k 电话信道模型,无多余重采样。
七、避坑指南
- 不要只调模型:模型从 800ms 优化到 400ms,可能不如把 VAD 从 1000ms 调到 450ms 来得明显。
- 静音阈值别调太激进:低于 300ms 容易抢话,老年客户、方言客户尤其明显,可按客群分别配置。
- 抖动缓冲不是越大越好:它在抗网络抖动的同时会直接增加延迟,内网或同机房部署时保持较小值。
- 合规先行:外呼必须使用合规号码资源,遵守呼叫时段与频次要求,尊重客户拒绝意愿;涉及个人信息的录音与文本要按规定存储和脱敏。
写在最后
AI 外呼的体验,一半在"说什么",一半在"什么时候说"。延迟优化没有银弹,但有方法论:先量化,再拆解,最后流式化。 把这套方法跑通,你会发现很多"模型不够聪明"的抱怨,其实是"模型回得太慢"。
下期预告:AI 外呼到底该选哪个模型?大模型、小模型、端到端语音模型怎么取舍,附选型评测表。
📌 本文为「FreeSWITCH × AI」系列第 1 篇,专注 AI 智能呼叫的工程落地。你在项目里遇到了什么问题?欢迎留言,后续文章优先解答。
注:文中耗时为常见经验区间,实际效果取决于厂商、网络与部署环境,请以实测为准。