

导读:FreeSWITCH 接大模型的最后一公里——用 mod_taering_stream 打通 WebSocket 实时双向音频流,下行 PCM 直接注入不落盘,原生支持插话打断(Barge-in)与已播进度回报。
一、先说一个真实的痛点
这两年做 AI 电话机器人、智能外呼的团队越来越多。ASR 有了流式识别,大模型能实时对话,TTS 也能流式合成,看起来“拼起来”就是一个能打电话的 AI。
但真正动手的人都知道,最难的一环往往不在 AI,而在 FreeSWITCH 和 AI 之间那条音频通道:
- 用
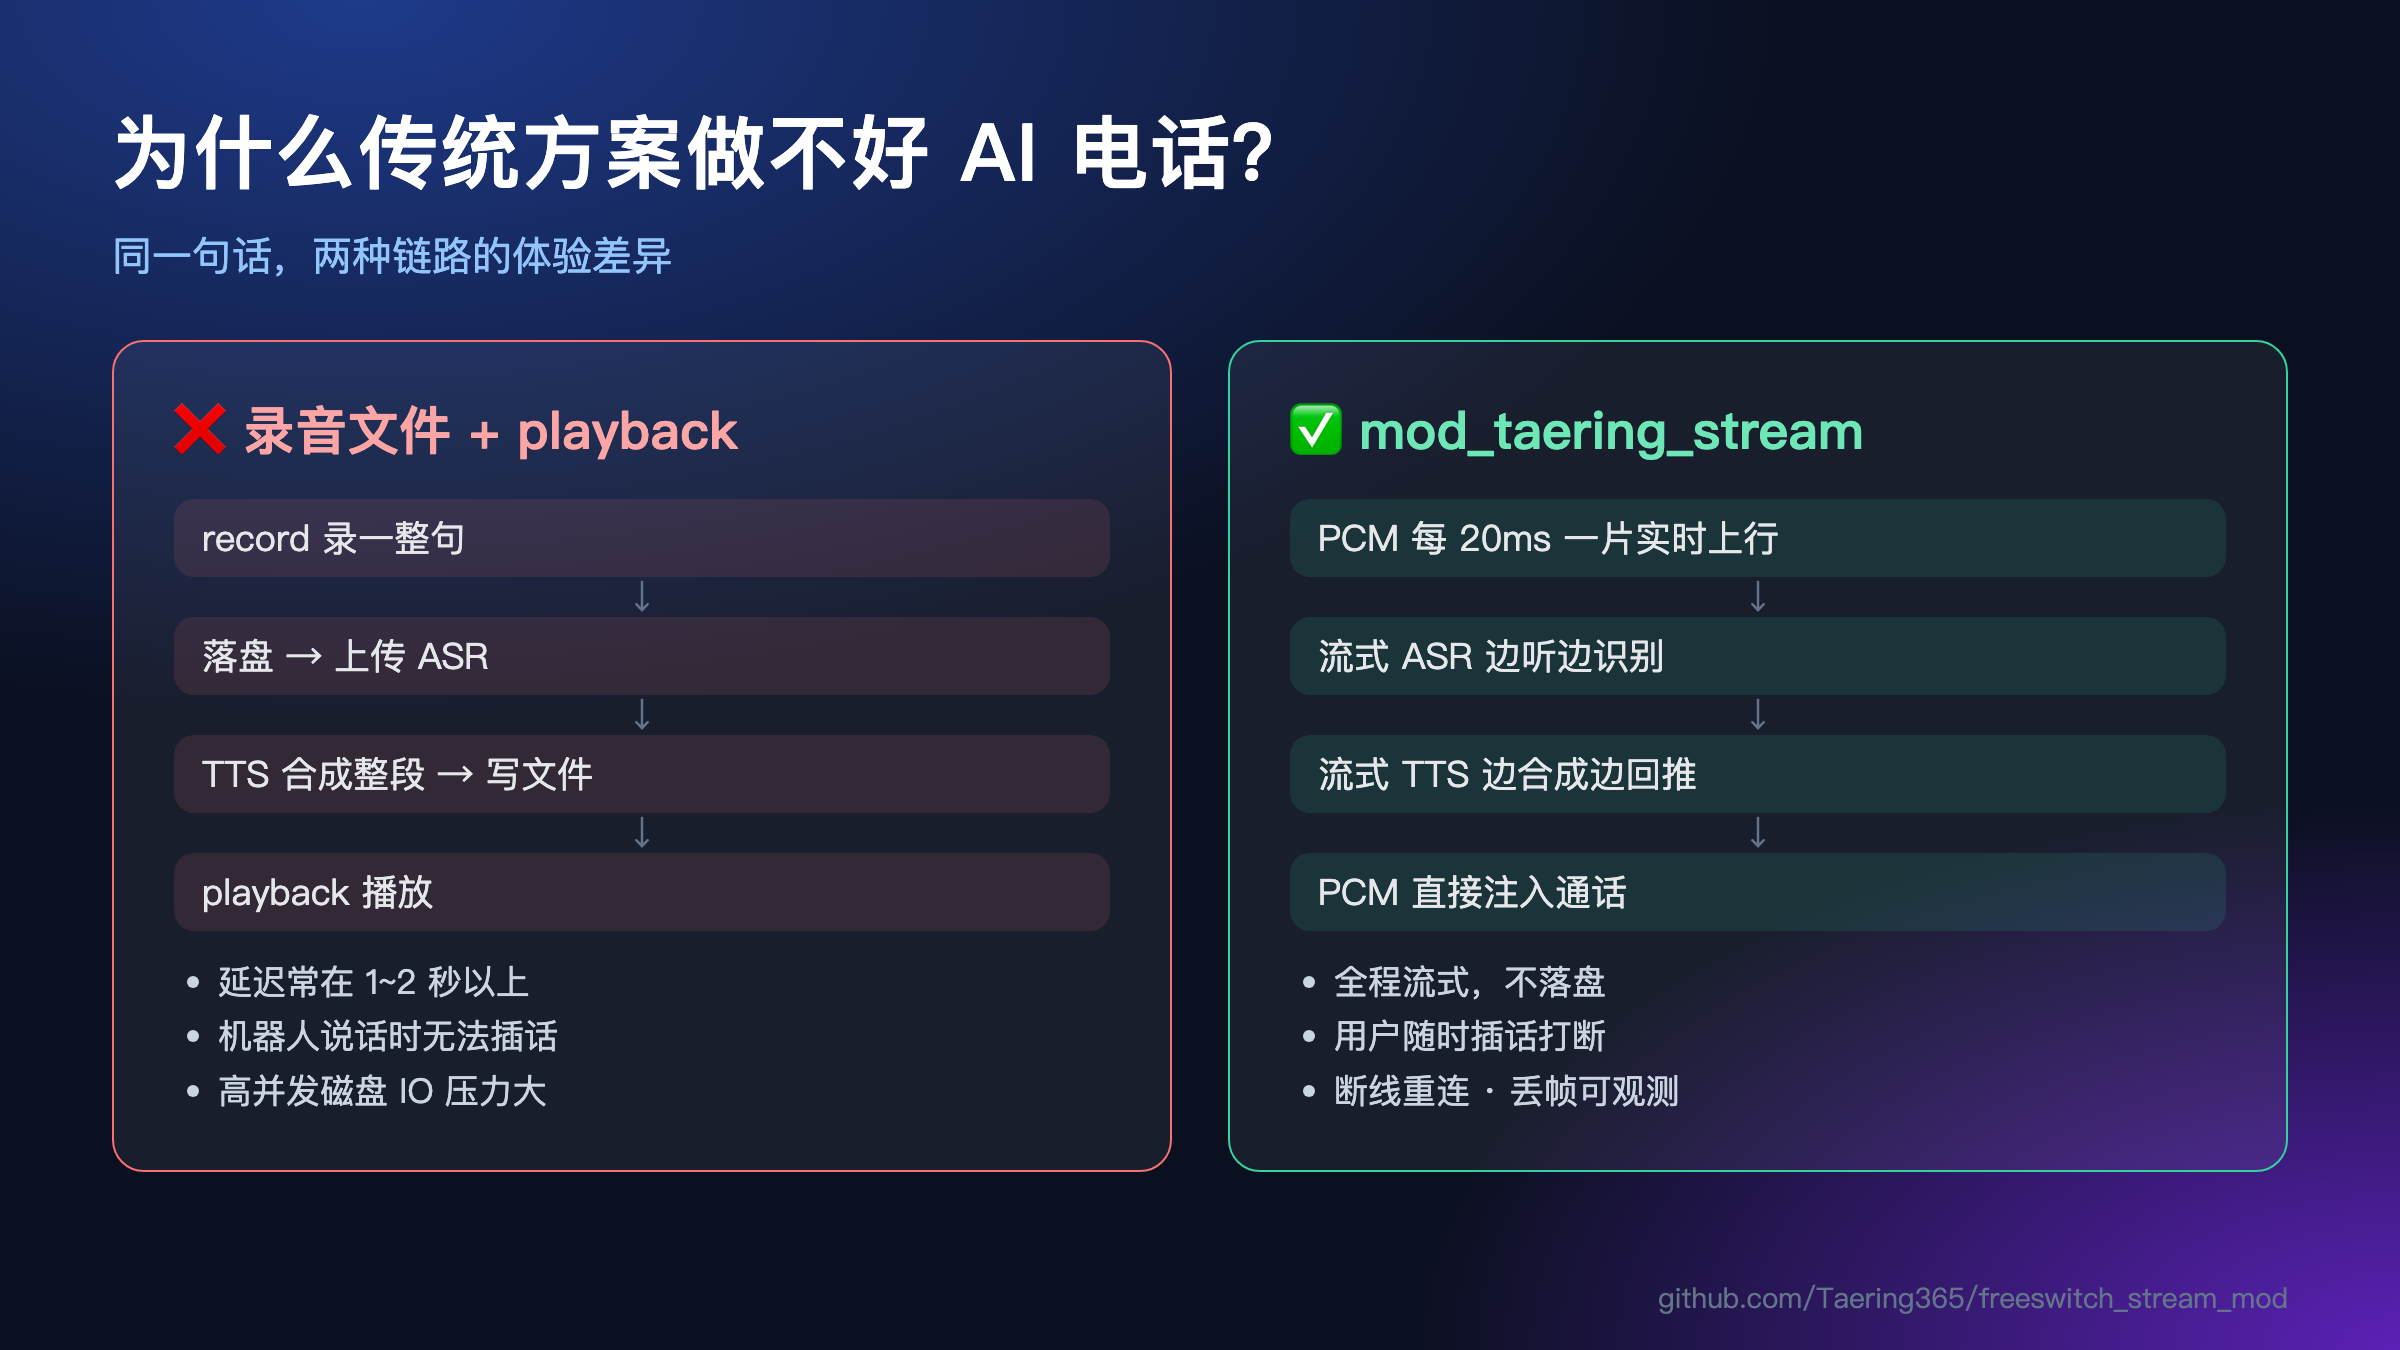
record录音再送 ASR、用playback播 TTS 文件?延迟动辄一两秒,机器人说话时用户根本插不上嘴,体验像在跟老式 IVR 对话。 - 用 ESL 轮询 + 文件落盘?几十路还行,上百路时磁盘 IO、线程数一起报警。
- 找开源推流模块?上行推流大多没问题,可下行常常是 base64 → 落盘 → 再播放,打断、播放进度、重连、幂等这些生产必需的能力,基本都得自己补。
- 自己写一个 media bug 模块?WebSocket 客户端、断线重连、ring 缓冲、采样率、loopback 腿方向、多线程模型……每一个都是坑。
我自己在做 AI 外呼项目时,把这些坑一个个踩了过来,最后把这一层沉淀成了一个独立的 FreeSWITCH 模块:mod_taering_stream。
二、它是什么
一句话:mod_taering_stream 是一个 FreeSWITCH 实时双向音频流模块,让通话音频通过 WebSocket 实时进出你的 AI 后端,并内置插话打断能力。
整体链路非常简单:
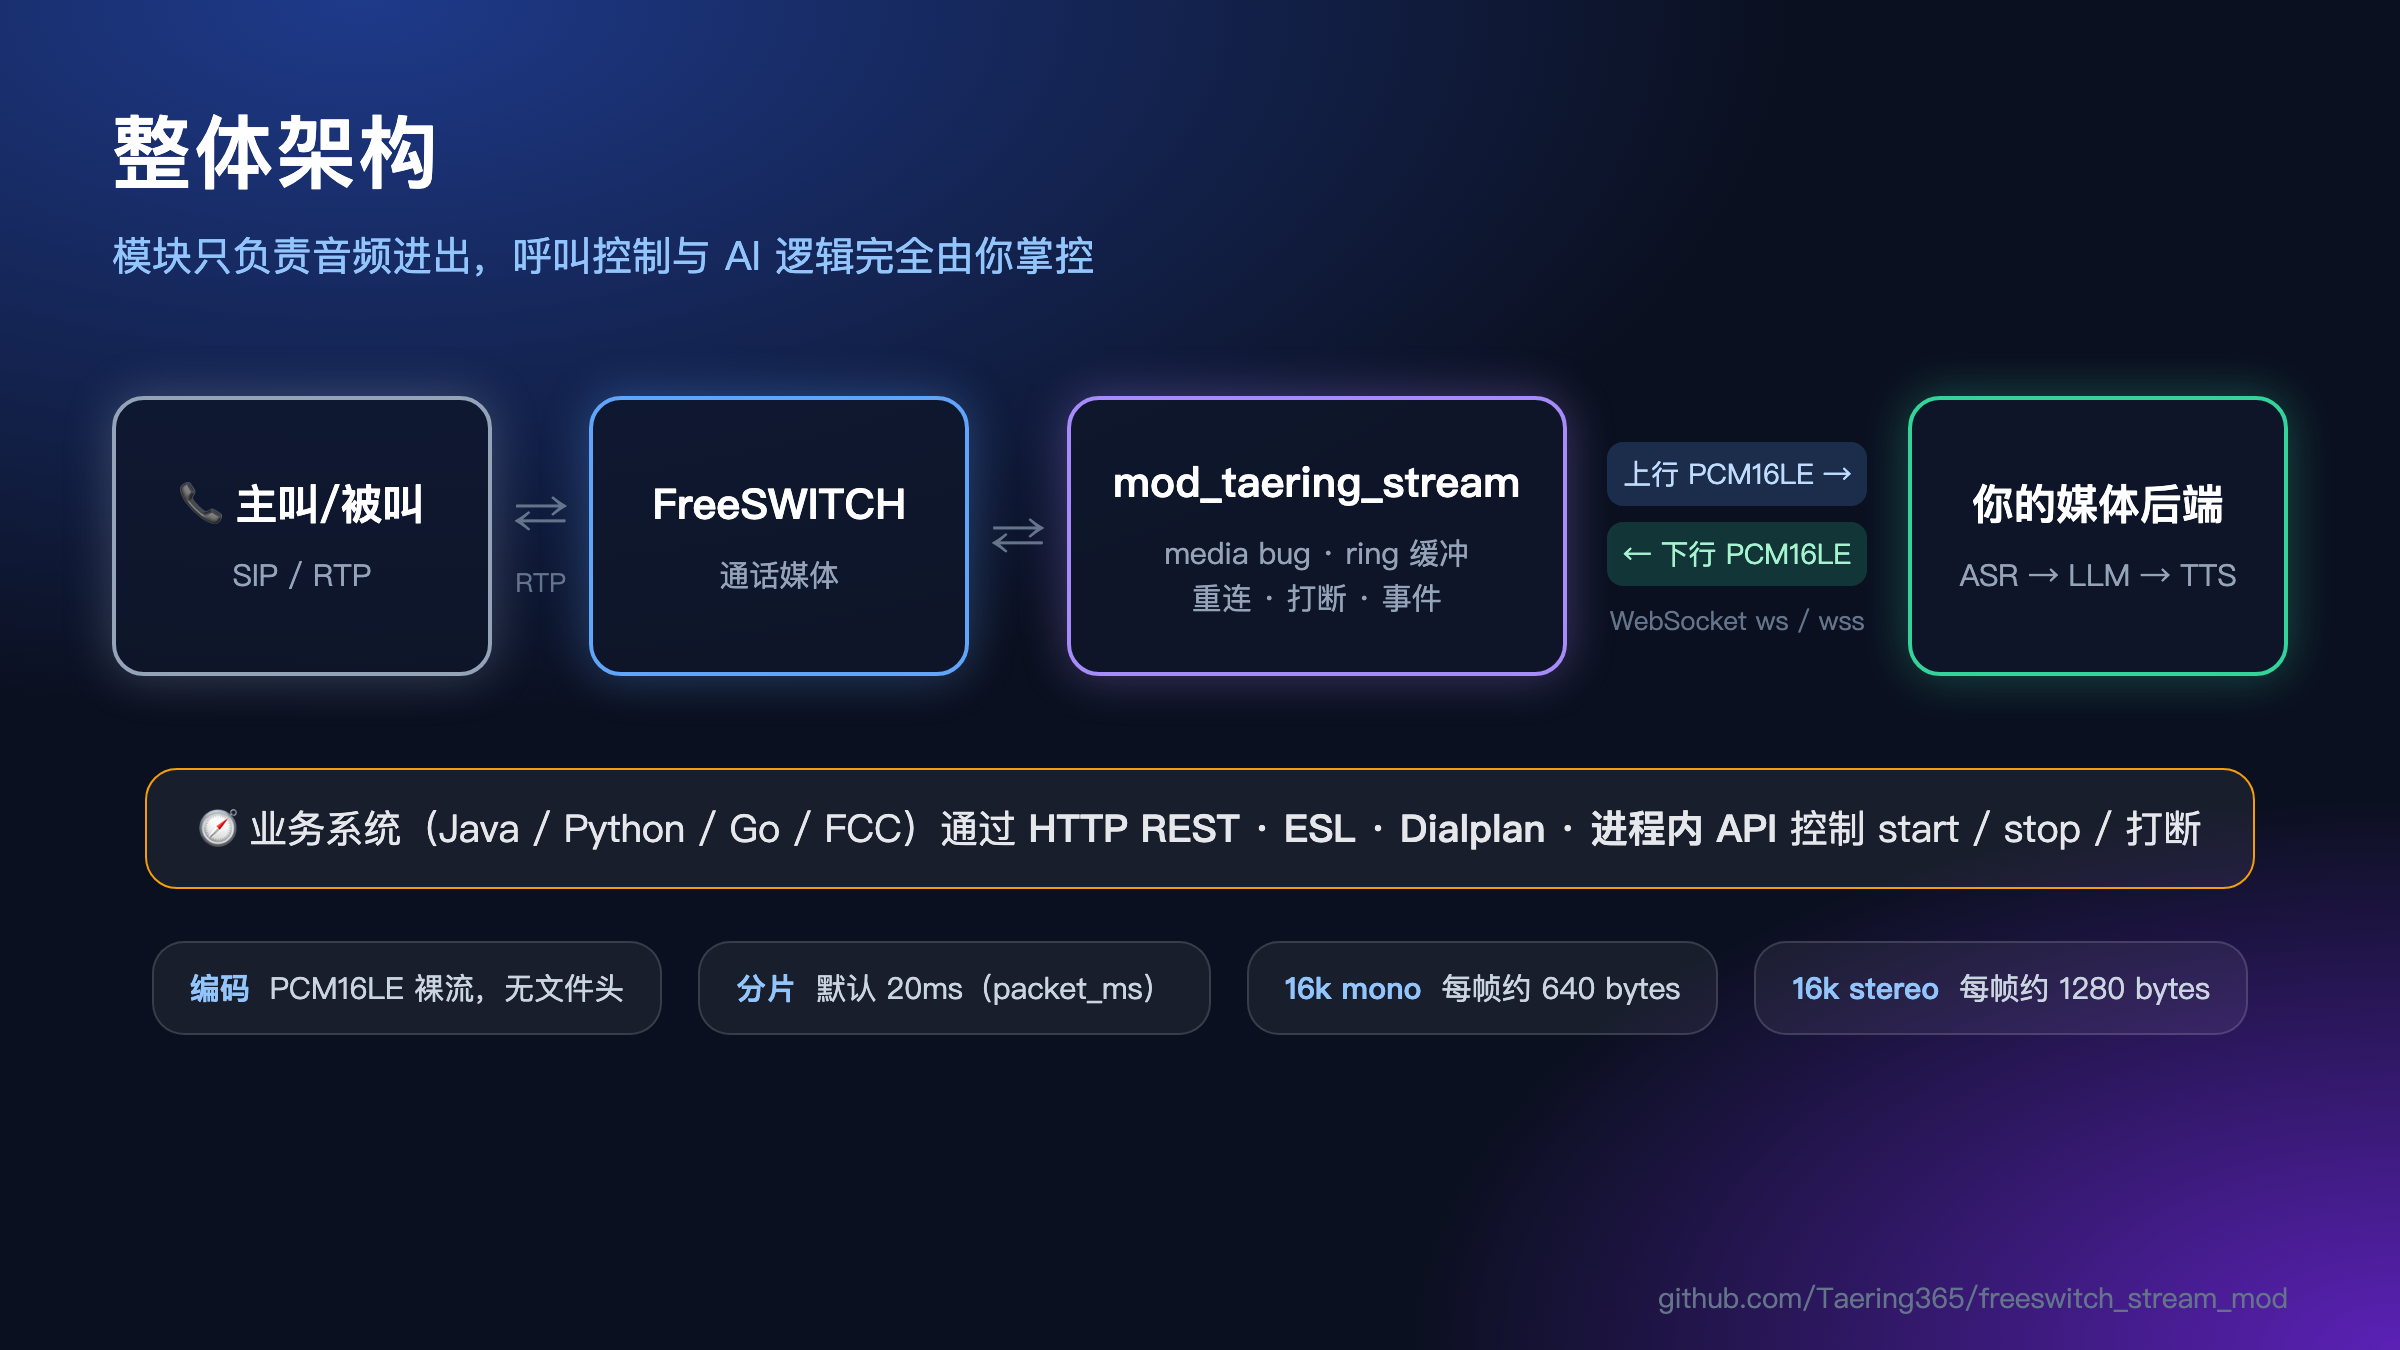
- 上行链路:主叫/被叫 RTP 媒体进入 FreeSWITCH 后,由
mod_taering_stream按 20ms 一片实时切出PCM16LE二进制帧,通过 WebSocket 推给你的媒体后端(ASR → LLM → TTS)。 - 下行链路:媒体后端流式回推
PCM16LE二进制帧,mod_taering_stream直接注入当前通话,用户即刻听到 AI 回复。
模块只做一件事:把音频高效、稳定地搬进搬出。外呼、应答、桥接、挂机等呼叫控制它一概不碰,所以可以无缝嵌入你现有的任何呼叫控制系统。
三、几个我认为最有价值的设计
1. 下行 PCM 直接注入,不落盘、不走 playback
后端回推的单声道 PCM16LE 二进制帧,会直接叠加进通话的媒体帧里。流式 TTS 合成出一小段,就能立刻播出一小段,没有“等整句合成完 → 写文件 → 播放”的延迟。
对于老系统,模块也兼容 base64 音频和 wav/mp3/ogg 文件播放,但生产主路径推荐二进制 PCM —— 延迟最低,并发最好。
2. 插话打断(Barge-in)是一等公民
AI 电话体验好不好,很大程度取决于用户能不能随时打断机器人。
模块提供了完整的打断能力:
- 后端判断用户插话后,调用
interrupt_playback(HTTP / ESL / CLI 均可),或直接在 WebSocket 上发一条{"type":"clear"}; - 模块立即清空下行播放队列;
- 同时通过
taering_stream::play事件回报interrupted,并带上这一批音频已经播放了多少毫秒(Played-Ms)。
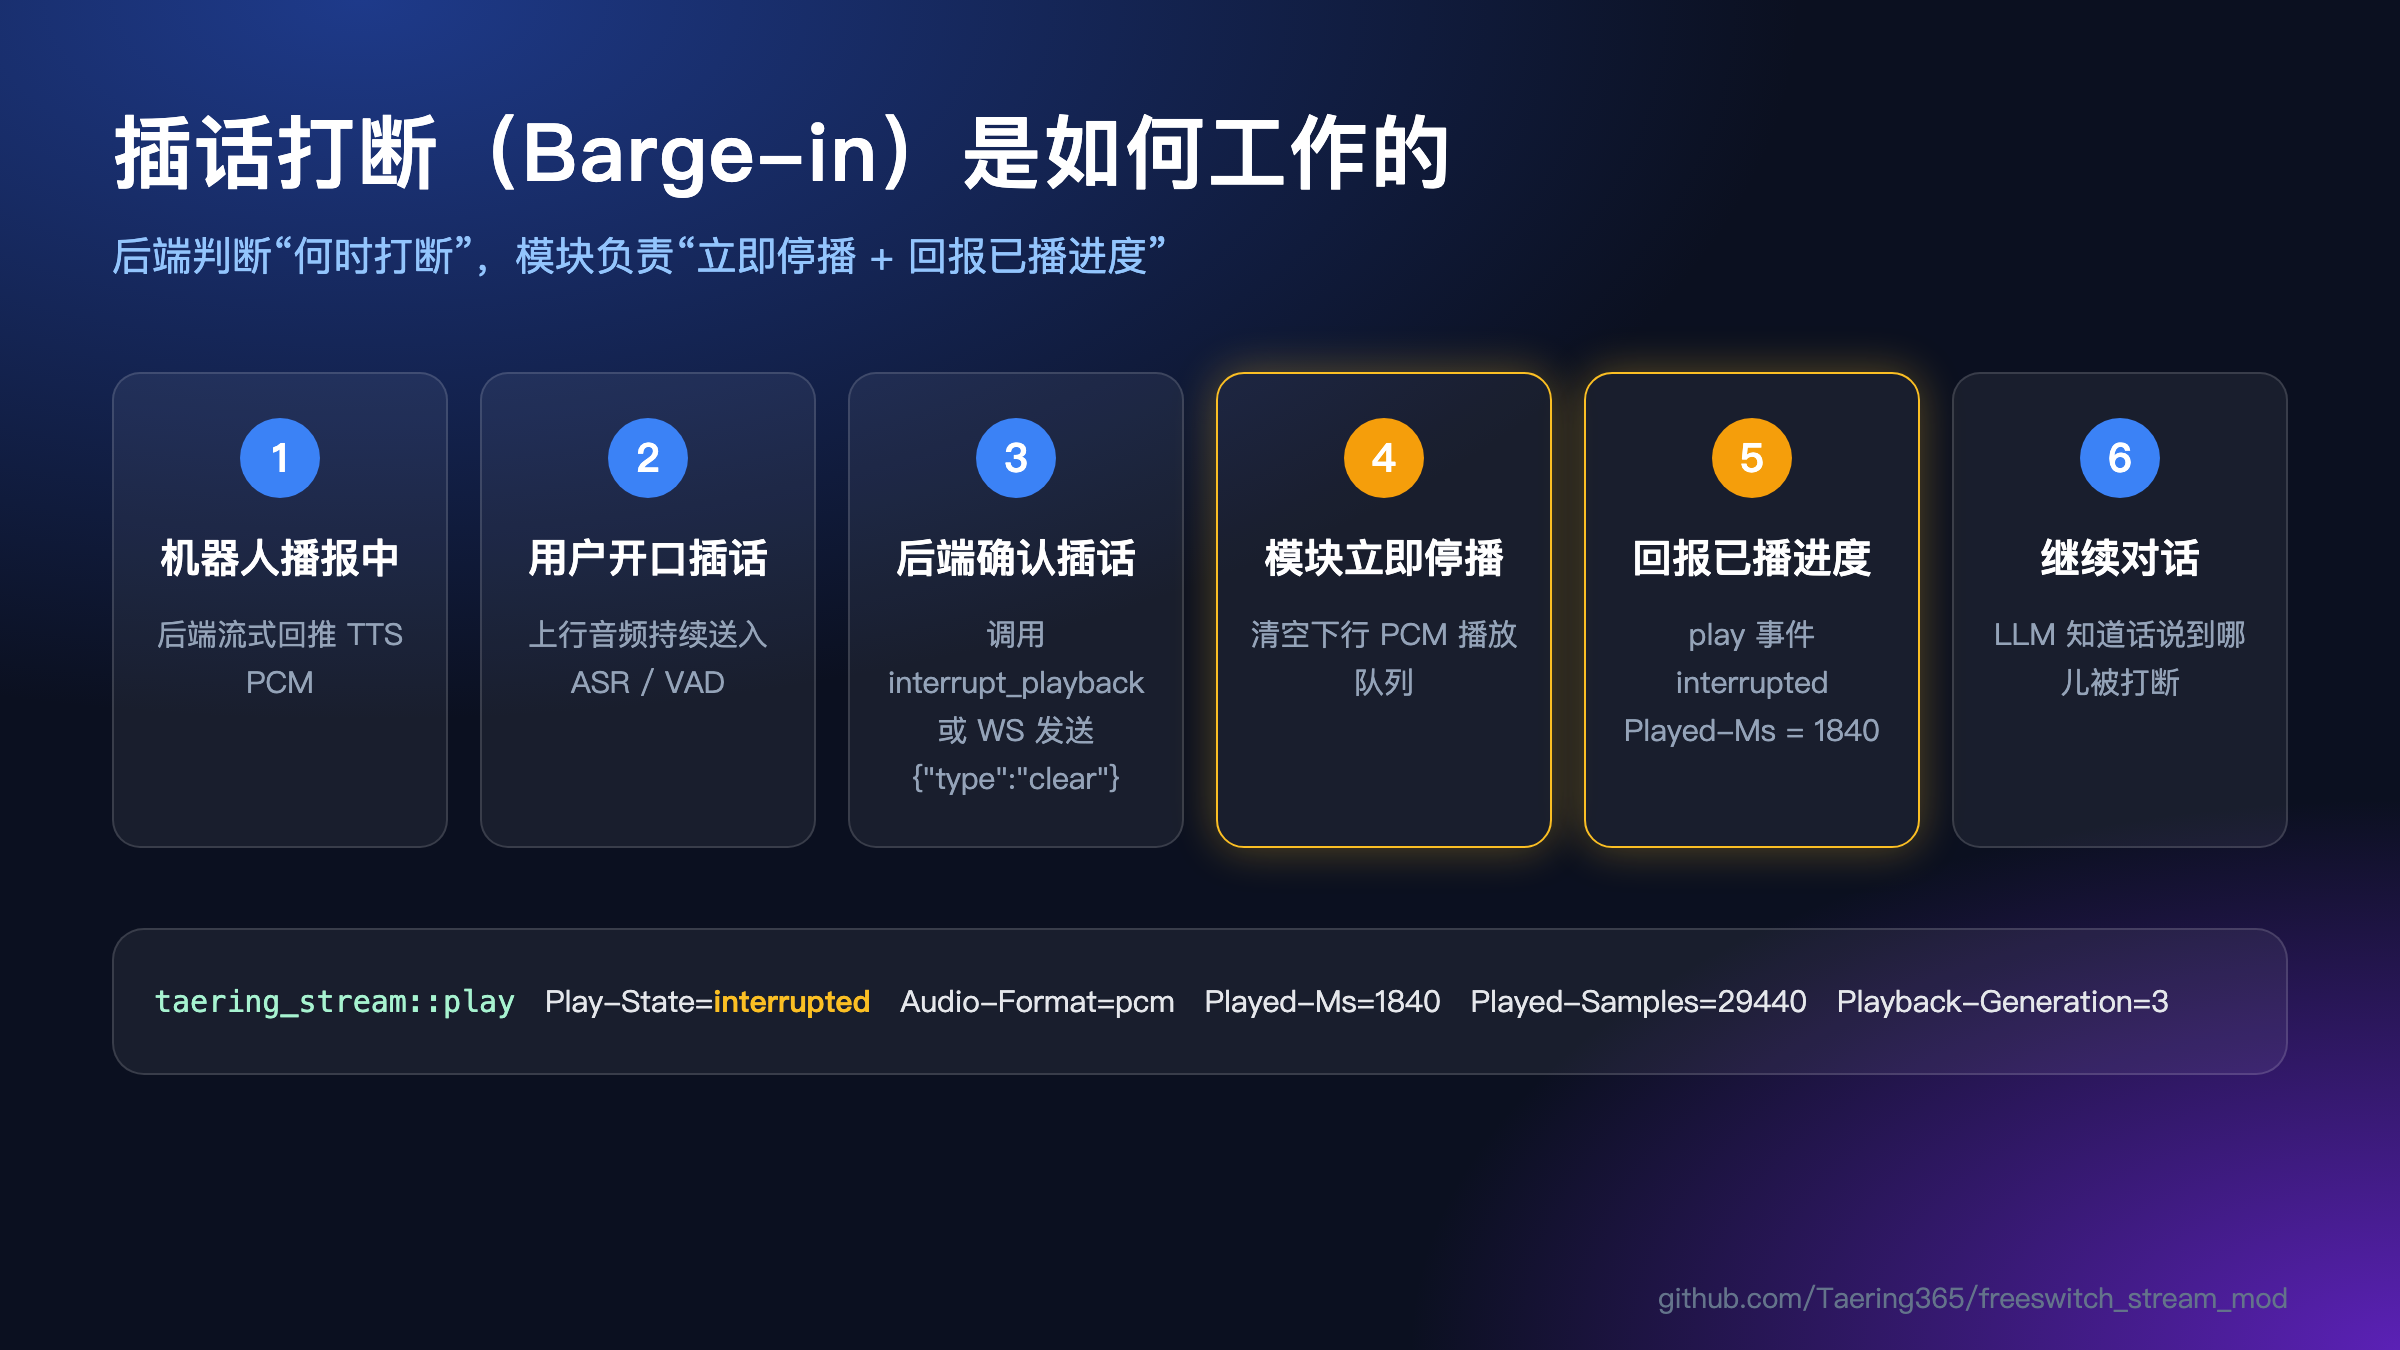
最后这一点很关键:有了已播进度,大模型就能知道“用户是在我说到哪儿时打断的”,上下文管理会准确得多。
3. 五种调用方式,总有一种适合你
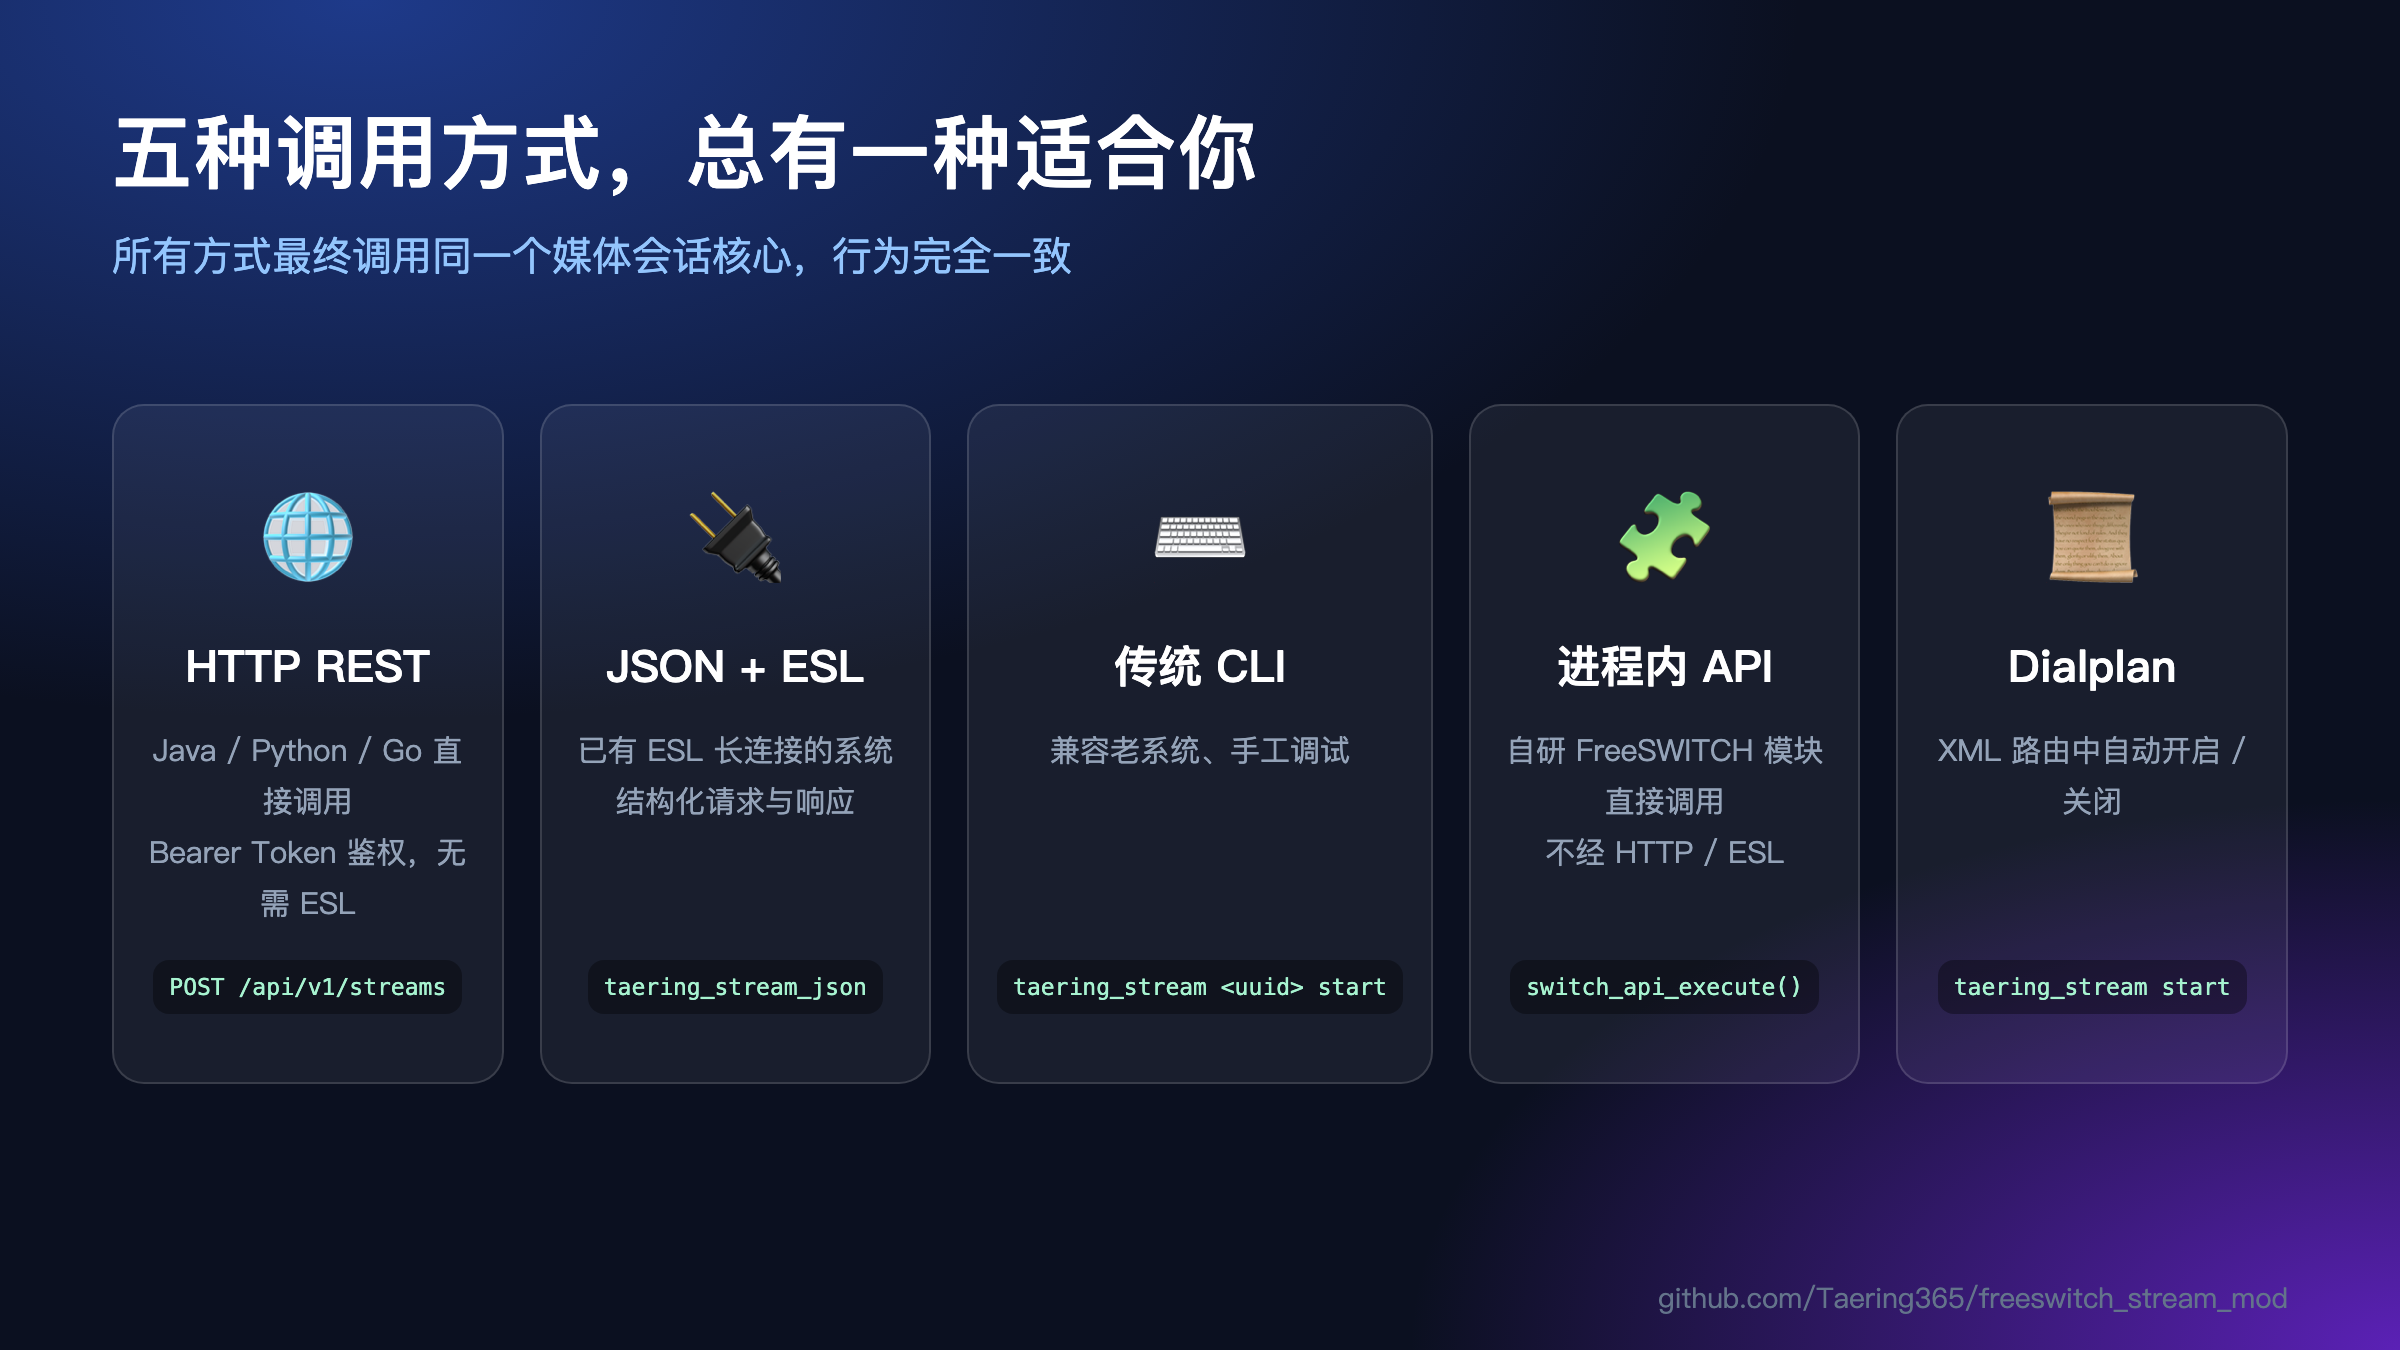
| 方式 | 适合谁 |
|---|---|
| HTTP REST | Java / Python / Go 后端,不想引入 ESL |
taering_stream_json + ESL | 已有 ESL 长连接的系统 |
传统 taering_stream 命令 | 兼容老系统、手工调试 |
| FreeSWITCH 进程内 API | 自研 FS 模块直接调用 |
| Dialplan application | 在 XML 路由里自动开启/关闭 |
比如用 HTTP 启动一路推流,只需要:
import requests

resp = requests.post(
    "http://127.0.0.1:18081/api/v1/streams",
    headers={"Authorization": "Bearer <your-token>"},
    json={
        "channel_id": "8bb70000-1111-2222-3333-444455556666",  # FreeSWITCH 通道 UUID
        "external_id": "call_01KABCDEF",                        # 你的业务 call_id
        "request_id": "media-20260827-001",                     # 幂等键,重试不会重复创建
        "ws_url": "ws://127.0.0.1:9000/stream",
        "mix_type": "mono",
        "sample_rate": 16000,
    },
    timeout=5,
)
print(resp.json())   # 返回 stream_id 与媒体状态
或者在 Dialplan 里一行搞定:
<action application="taering_stream" data="start"/>
4. 为生产环境而生的细节
这些是我在真实项目里踩坑后加上的:
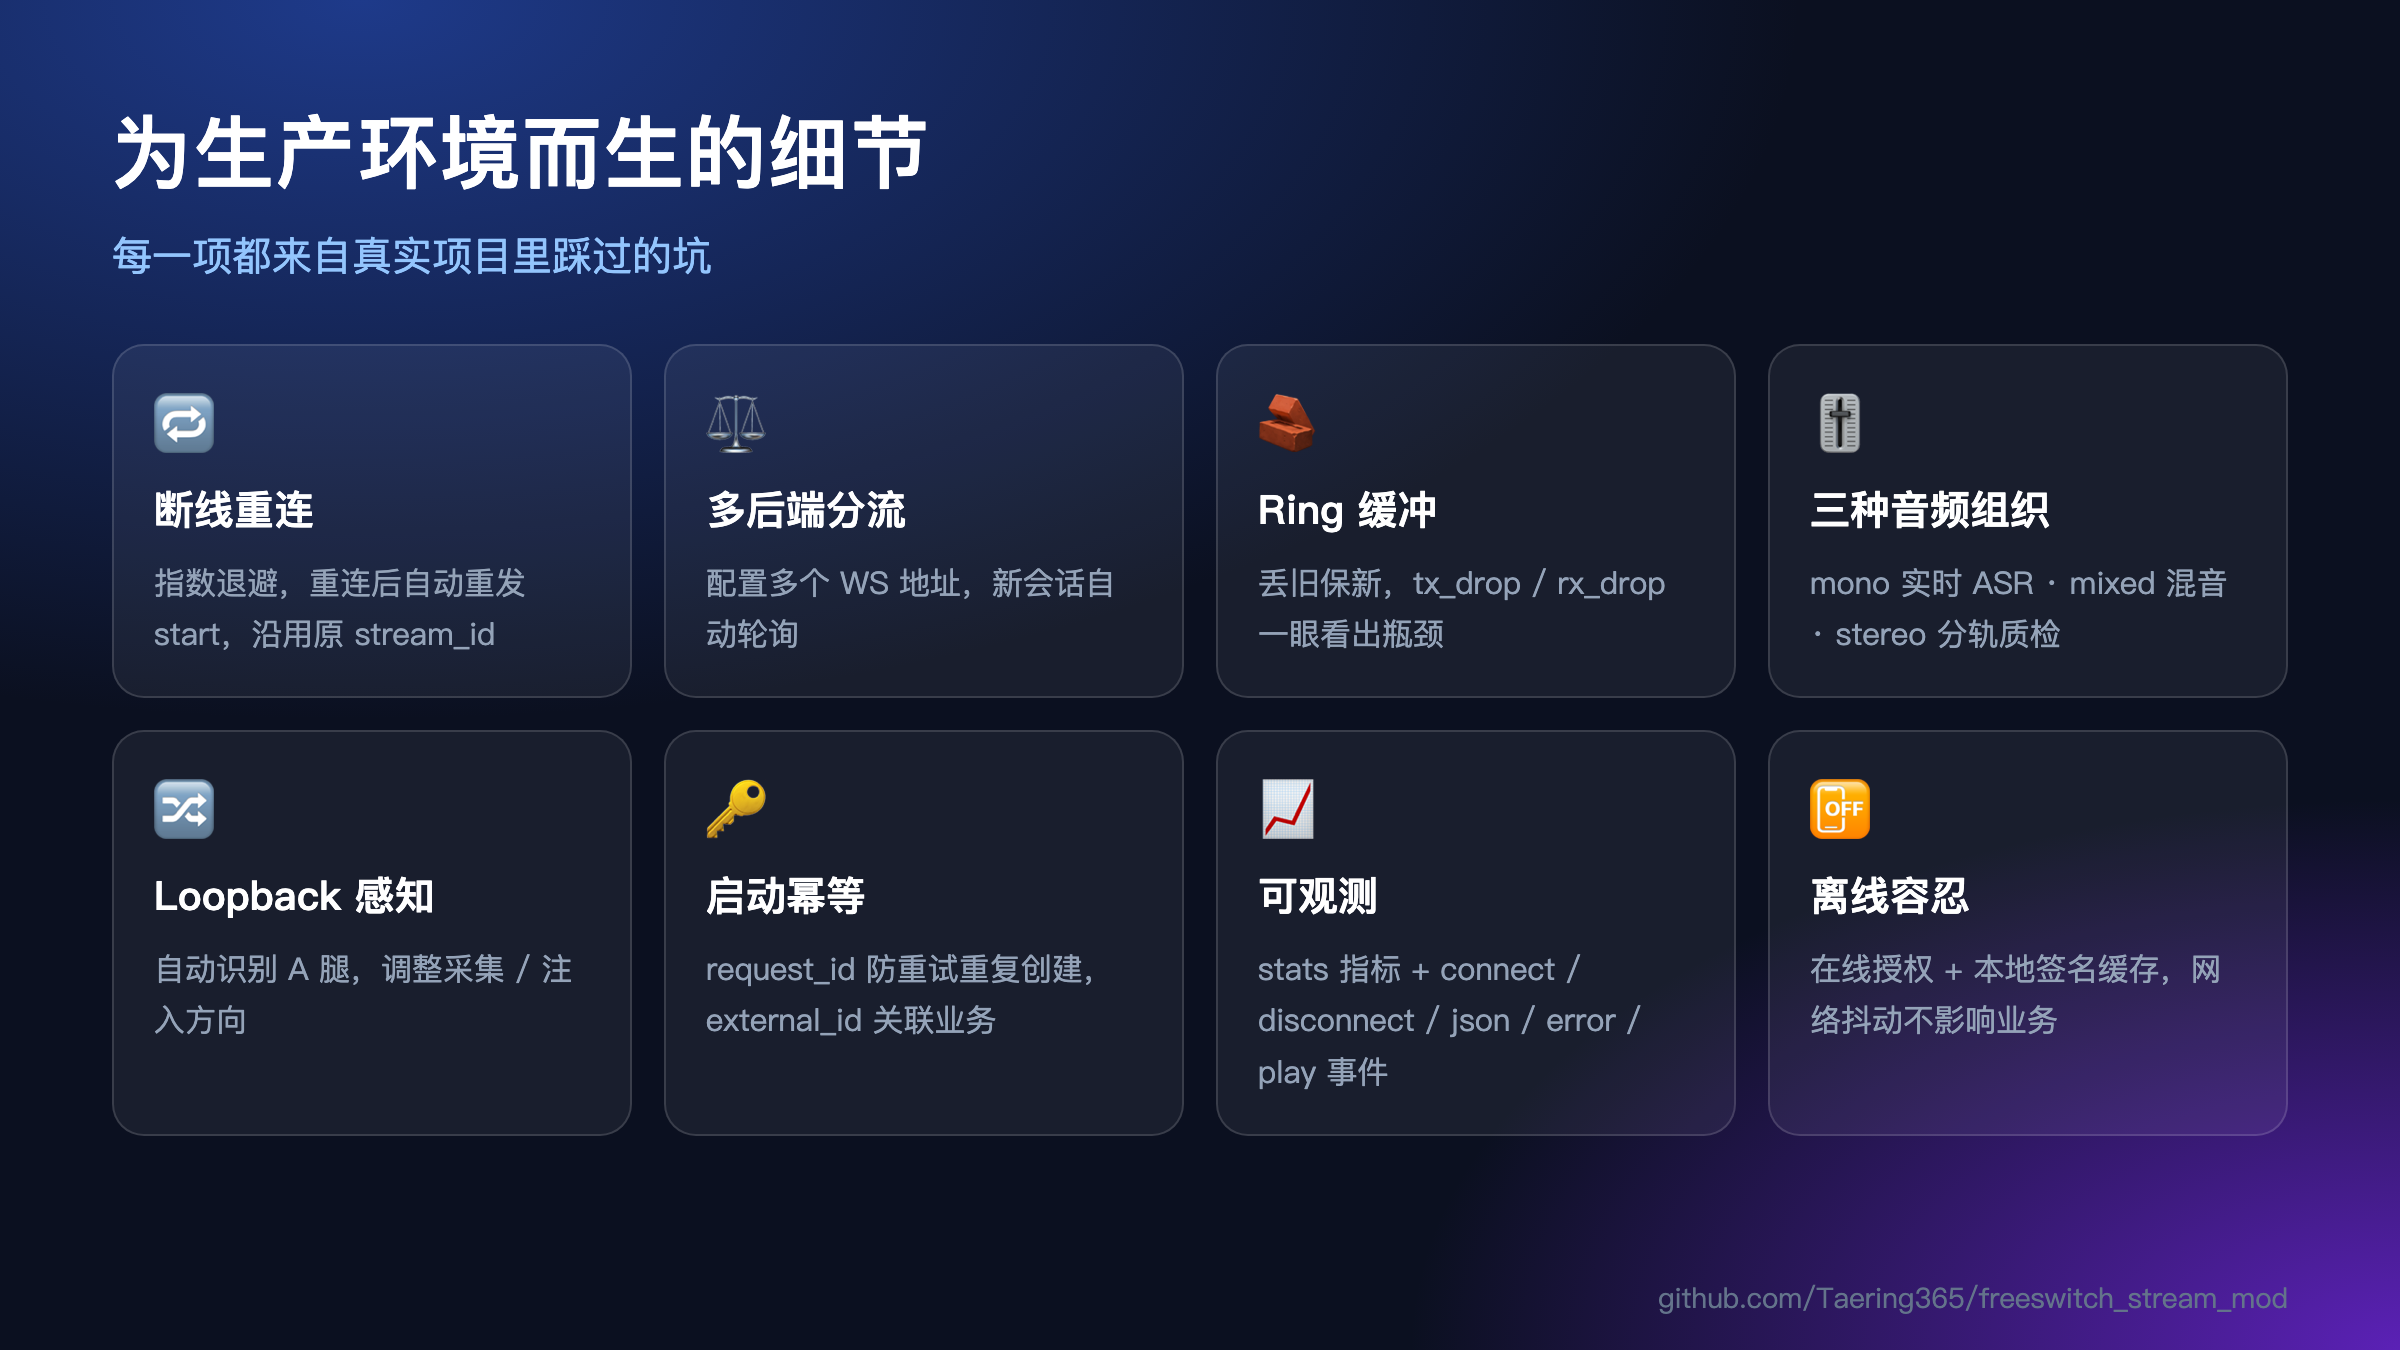
- 断线重连:指数退避,重连成功后自动重发
start,沿用原stream_id; - 多后端分流:配置多个 WebSocket 地址,新会话自动轮询;
- ring 缓冲 + 丢帧计数:后端处理不过来时丢旧保新,
tx_drop/rx_drop一眼看出瓶颈; - 三种音频组织:
mono用于实时 ASR,mixed用于混音分析,stereo左右声道分别是双方声音,方便做说话人分离和质检; - Loopback 感知:自动识别 loopback A 腿并调整采集/注入方向,用过 loopback 的同学应该知道这有多省心;
- 启动幂等:
request_id保证网络抖动重试时不会对同一通话重复创建媒体流; - 可观测:
taering_stream stats运行指标 + 5 类自定义事件(connect / disconnect / json / error / play)。
四、后端要写多少代码?
非常少。下面是一个完整可运行的回声后端 —— 把用户的声音原样送回去,拨通后就能听见自己:
import asyncio, json, websockets

async def echo(ws):
    start = json.loads(await ws.recv())   # 首帧:start 控制消息(含 uuid、采样率等)
    print("start:", start)
    async for msg in ws:
        if isinstance(msg, bytes):
            await ws.send(msg)            # 收到 PCM16LE,原样回送
        elif msg.startswith("{") and json.loads(msg).get("type") == "stop":
            break

async def main():
    async with websockets.serve(echo, "127.0.0.1", 9000):
        await asyncio.Future()

asyncio.run(main())
把 await ws.send(msg) 换成“送入流式 ASR → 大模型 → 流式 TTS → 回推 PCM”,一个可以被打断的 AI 电话机器人就成型了。ASR/TTS 选型完全自由:阿里云、腾讯云、讯飞、火山引擎,或者自部署的 FunASR、Whisper、CosyVoice 都可以。
五、适合哪些场景
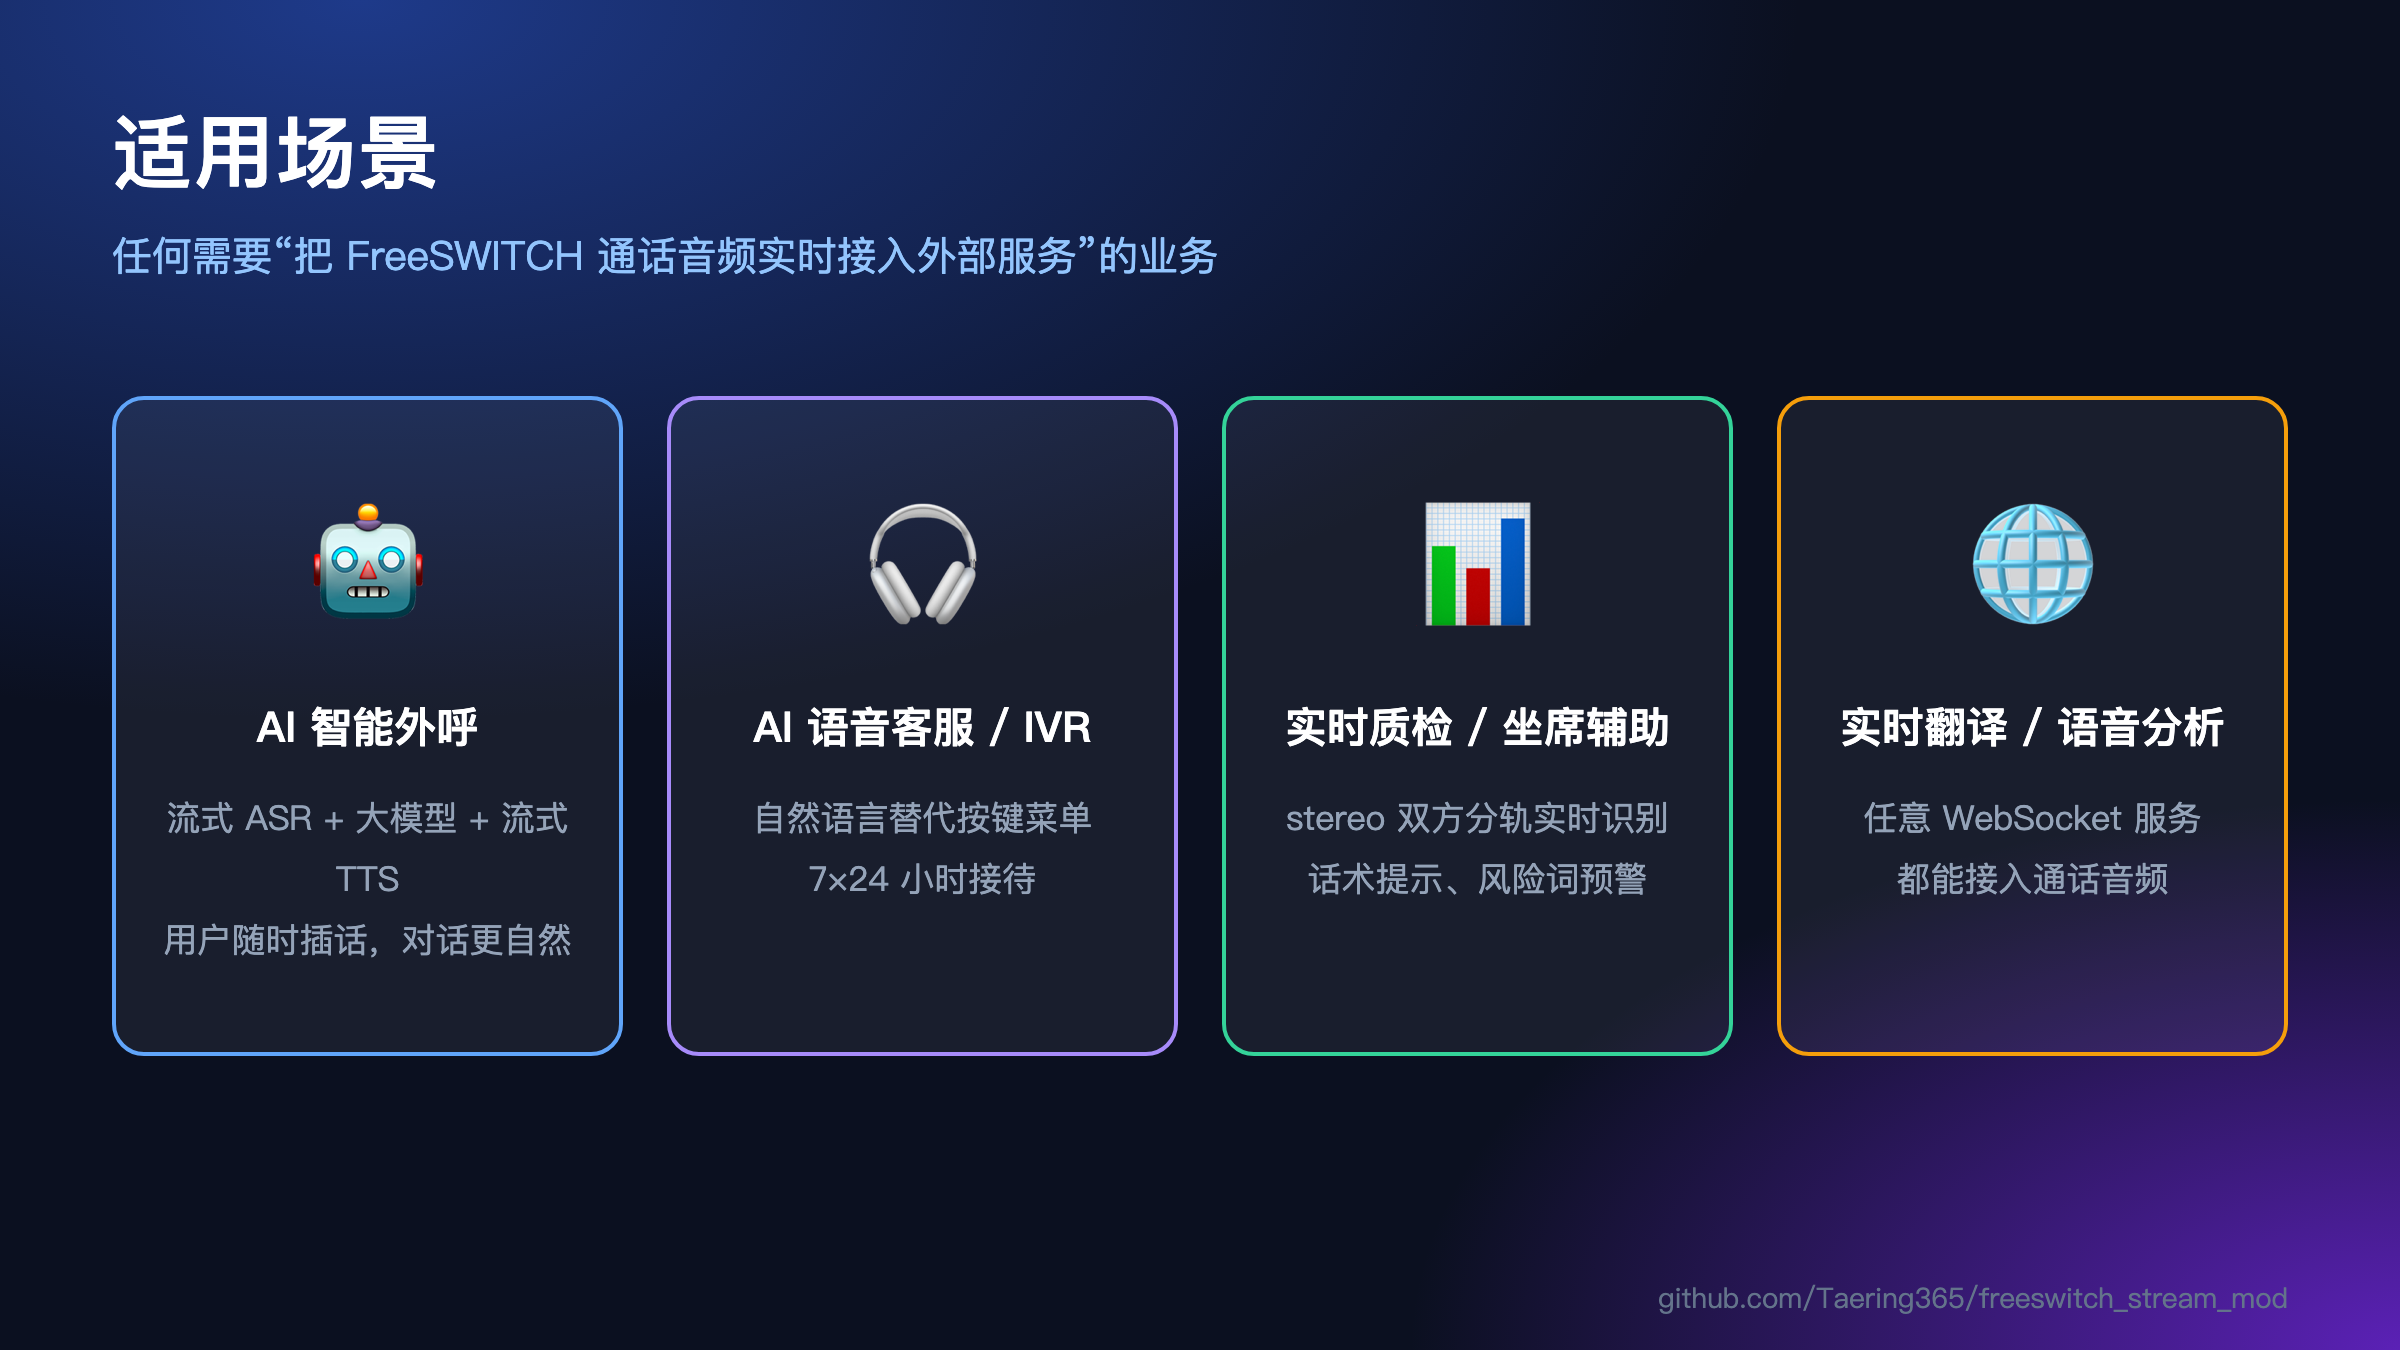
- 🤖 AI 智能外呼、电话机器人
- 🎧 AI 语音客服、智能 IVR(用自然语言替代按键菜单)
- 📊 实时质检、坐席辅助(stereo 分轨实时识别,提示话术与风险词)
- 🌐 实时翻译、通话语音分析
- 🔧 任何需要“把 FreeSWITCH 通话音频实时接入外部服务”的场景
六、怎么试用
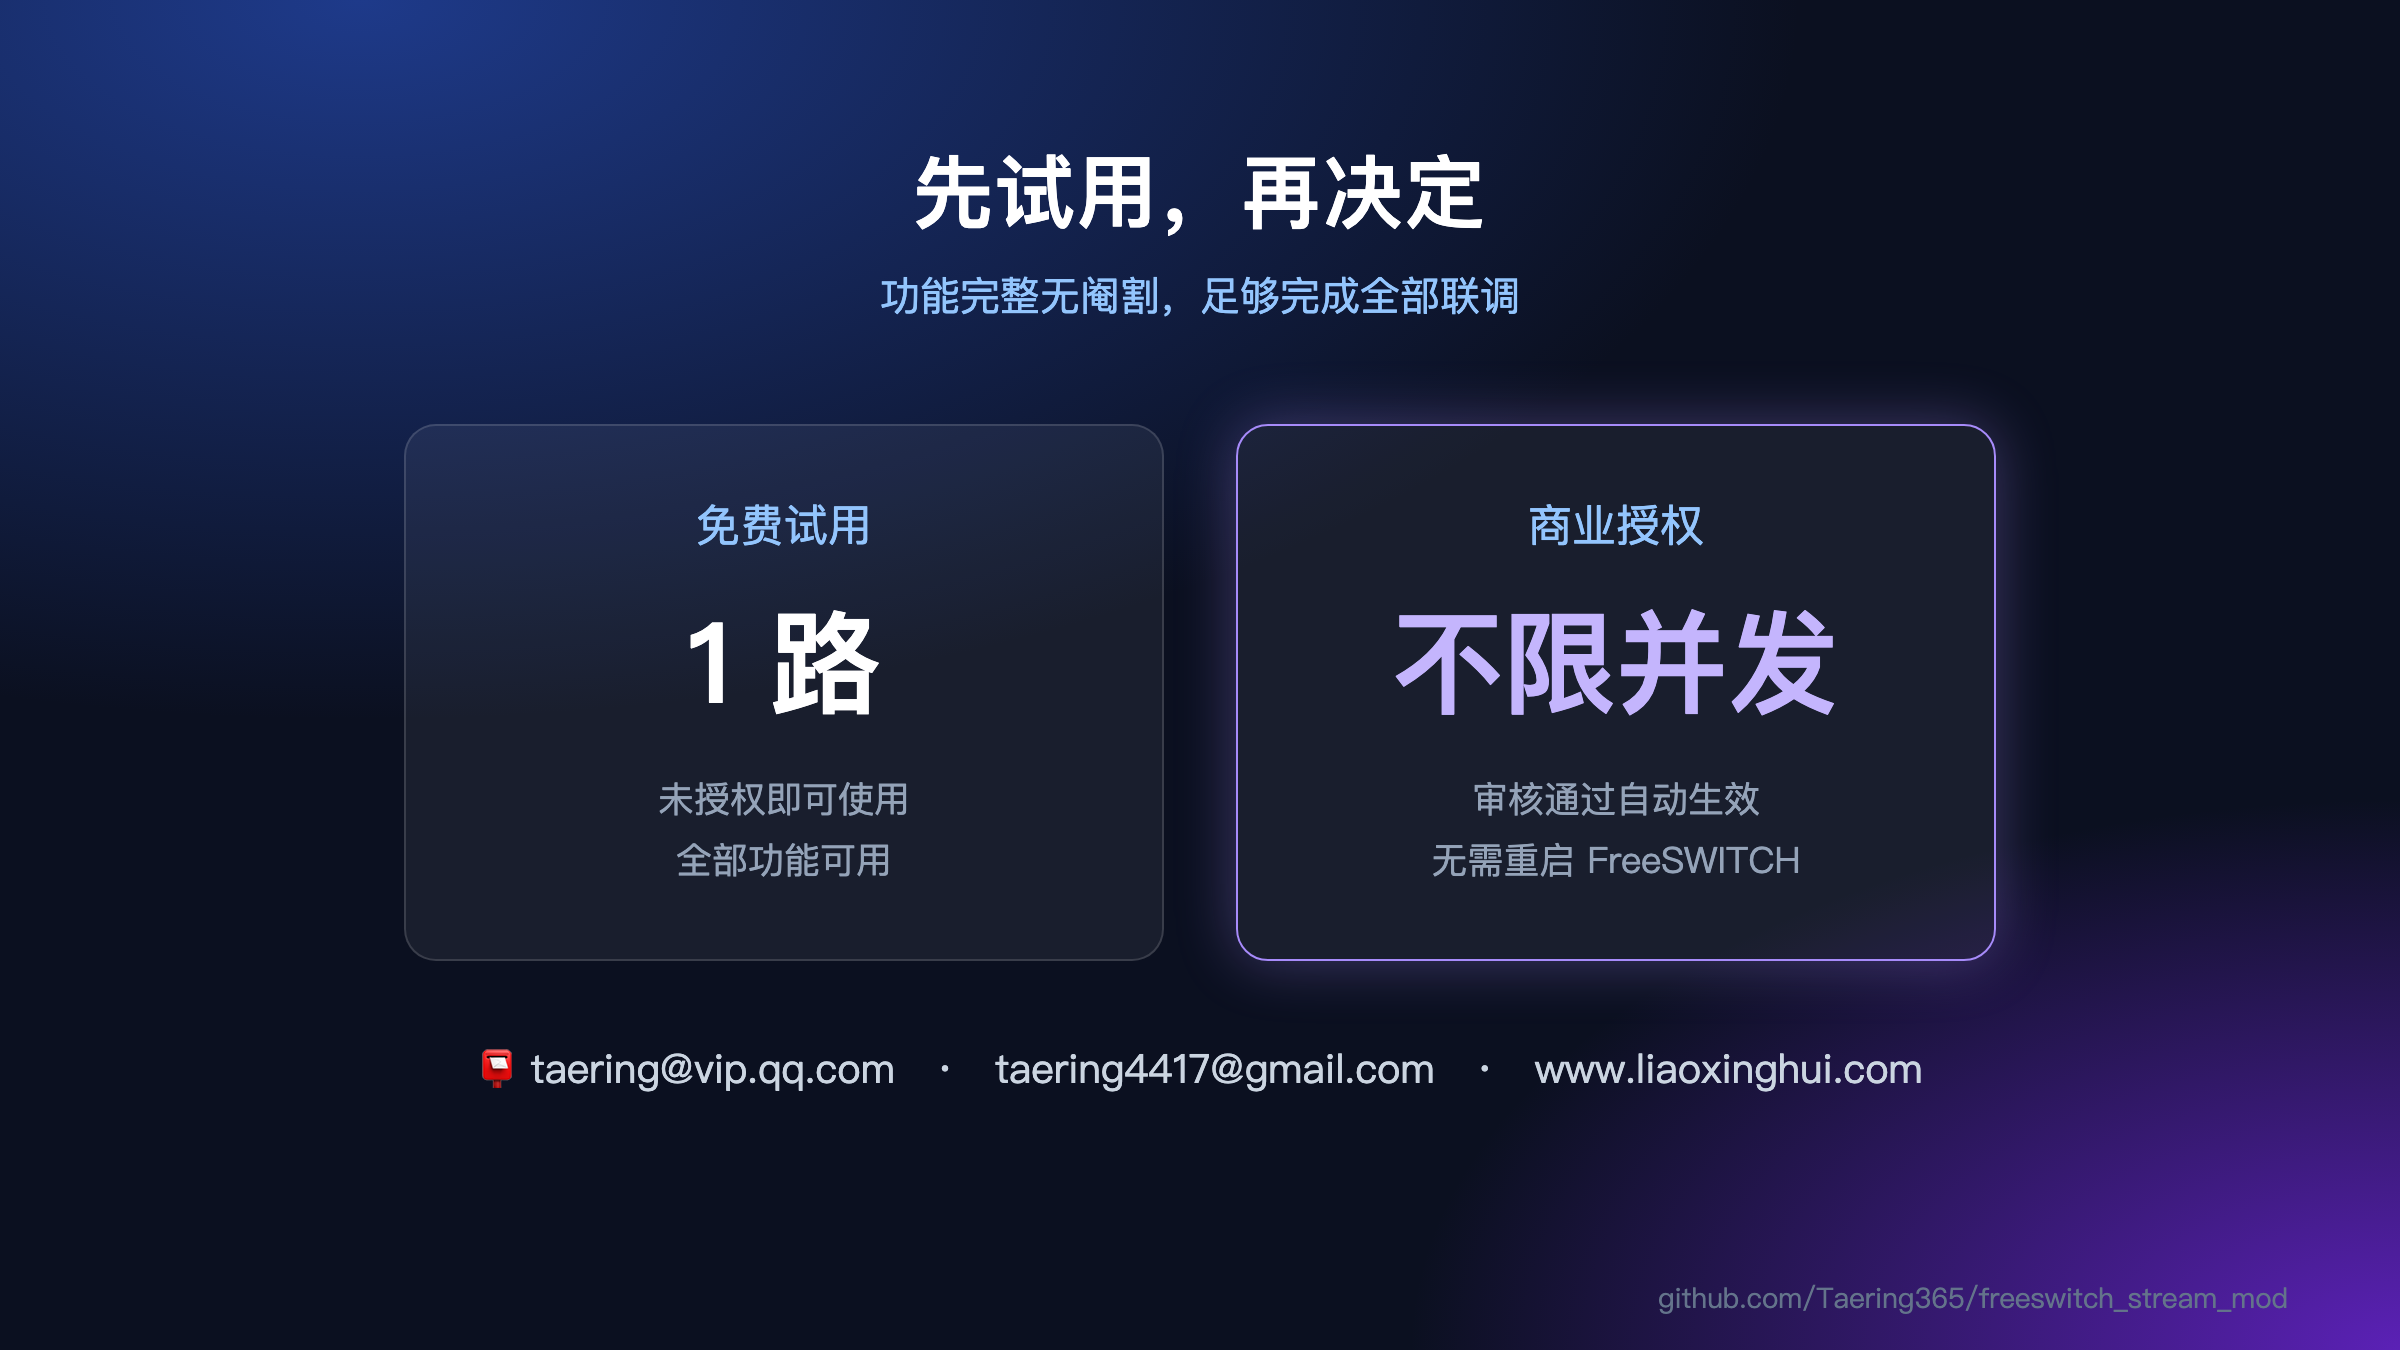
- 免费试用:未授权状态下即可使用,支持 1 路并发,功能完整,足够完成全部联调;
- 商业授权:授权后不限并发路数,后台审核通过自动生效,不需要重启 FreeSWITCH;
- 推荐环境:Debian 12 x86_64 + FreeSWITCH 1.10.x。
完整的接口文档、WebSocket 协议、全部 26 项配置说明、排障手册都在 GitHub README 里:
👉 GitHub 仓库:https://github.com/Taering365/freeswitch_stream_mod
获取交付包、商用报价或定制需求,欢迎联系我:
- 邮箱:
taering@vip.qq.com/taering4417@gmail.com - 个人主页:https://www.liaoxinghui.com
联系时附上 FreeSWITCH 版本、操作系统、预计并发和业务场景,我可以直接给出部署建议。
写在最后
AI 电话的门槛正在迅速降低,但“把声音实时、稳定地搬进搬出”这件事依然是很多团队的拦路虎。希望 mod_taering_stream 能帮你省下踩坑的那几周,把精力花在真正有价值的 AI 业务上。
如果觉得有用,欢迎到 GitHub 点个 ⭐ Star,也欢迎留言交流 FreeSWITCH + AI 的落地经验。